给数据库装上「大脑」
一个客户端,管好你的每一个数据库

— 开箱即用的数据源 —
MySQLMariaDBPostgreSQL 人大金仓OracleSQL Server DB2DerbyH2 达梦 DMClickHouseApache Doris SQLiteDuckDBRedis MongoDBElasticsearch 更多接入中…
17+
数据源驱动开箱即用
18×
结果集传输压缩比
100万+
行 / 分钟 · 大表传输实测
<1s
千万级表首屏响应

为「每天写 SQL 的人」打造

围绕真实任务组织,而不是堆功能清单 —— 每一项都有详细文档

⌨️

智能 SQL 编辑器

基于 Monaco(VS Code 同款内核):补全、格式化、多语句分块执行、逐段计时条、执行历史、SQL 片段库、模板变量 —— 大脚本也能条理清楚地跑。

查看文档 →
🤖

AI 全程加持

选段解释 / 优化 / 修错 / 诊断 / 自由对话,AI 给出的 SQL 先「看执行计划、试跑一次」再落地;「自主排查」还会自己巡检、给索引建议,把要改的东西做成变更单等你批准 —— 吃进去的数据不出你的网络。

AI 到底发了什么给模型 →
🧠

智能问数

一句中文直接问数:AI 挑表、写 SQL、真跑一遍,给出数字、图表与基于真实结果集的结论;图表本地切换不花 token,追问延续上下文。怎么用 →

🛡️

事务模式

一键开启:所有写语句不再自动提交。改完自查、不满意回滚、确认后提交 —— 配合其他会话的可见性规则,改数据不再心惊胆战。

查看文档 →
✏️

结果集直接编辑

双击单元格改值、攒缓冲、一次提交。WHERE 条件自动生成(优先主键,否则全列定位);翻页重跑后过期缓冲自动作废,绝不改错行。

查看文档 →
⚡

千万级结果集秒开

虚拟滚动 + 服务端分页 + 响应压缩(实测 4.2MB → 233KB)。总数异步统计不阻塞数据回显,大 JOIN 也能 1 秒见数。

查看文档 →
🧱

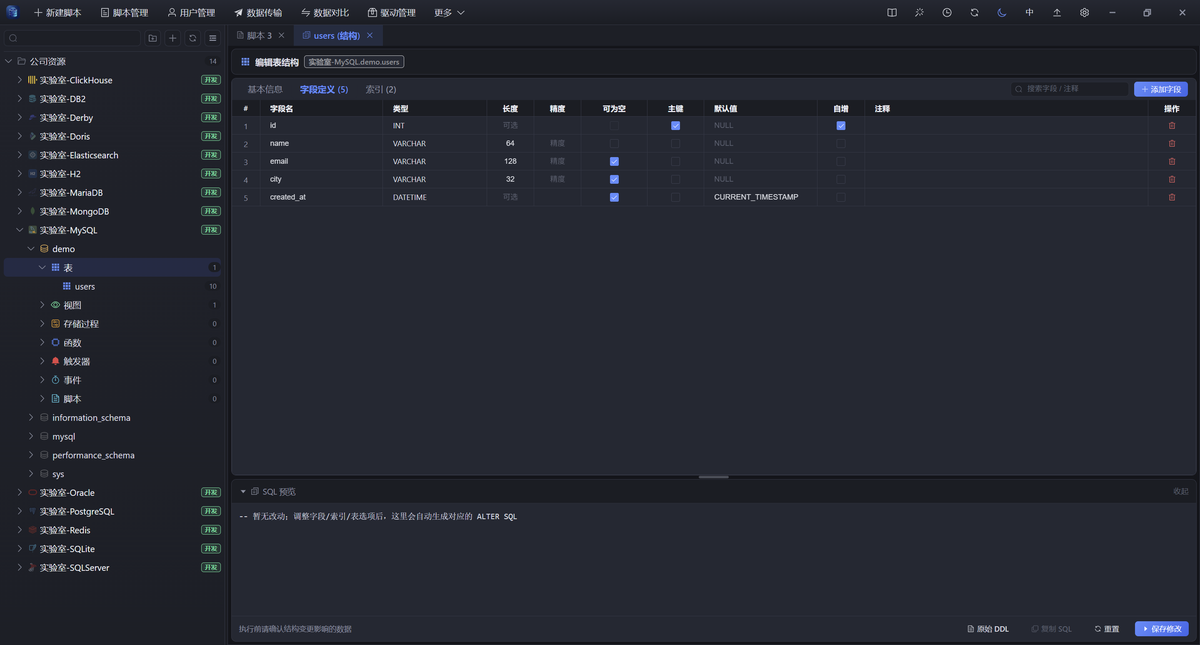
表结构与对象编辑

字段类型、默认值、注释、索引在表格里直接改,执行前先看到完整的 ALTER;视图、存储过程、函数、触发器、事件可查看 DDL 并转成 ALTER 继续编辑。

查看文档 →
🧑‍💼

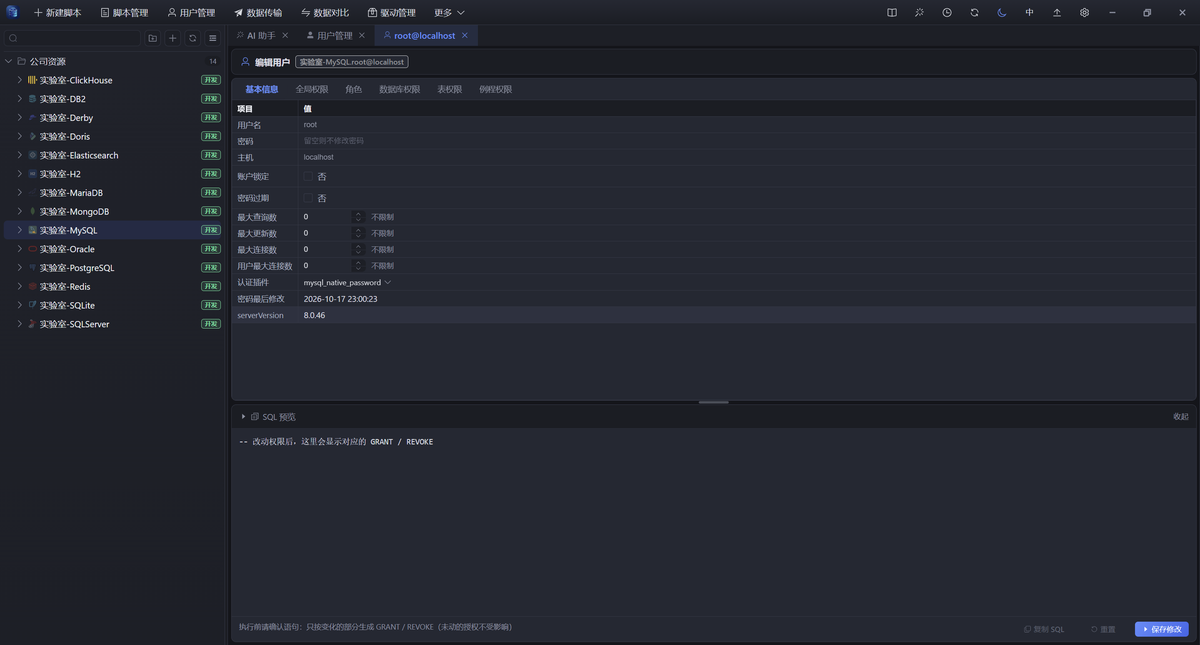
用户与权限管理

用户 / 角色清单按引擎适配,权限按「全局 / 服务器 / 库 / 模式 / 表 / 例程」分层勾选;每一次勾选都预览精确的 GRANT / REVOKE 差量,提交时只发变化的部分。

查看文档 →
📈

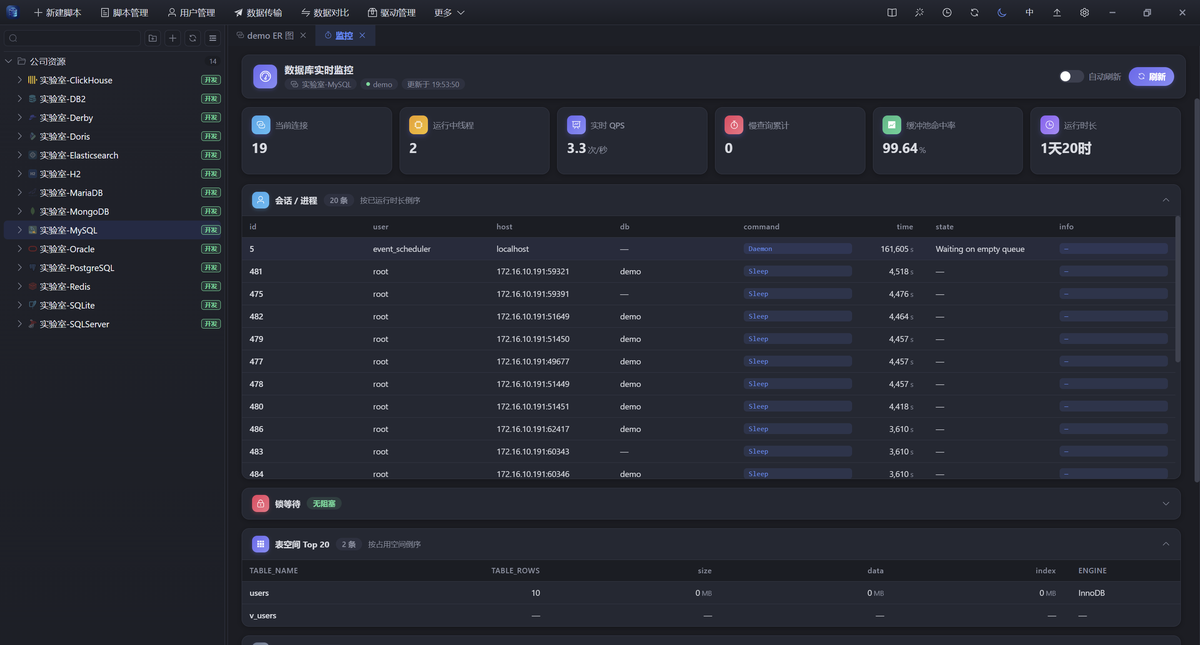
服务监控

会话、锁与库级指标集中看,可疑会话就地终止;不提供监控接口的引擎会如实说明,不给你画一张空图。

查看文档 →
🗺️

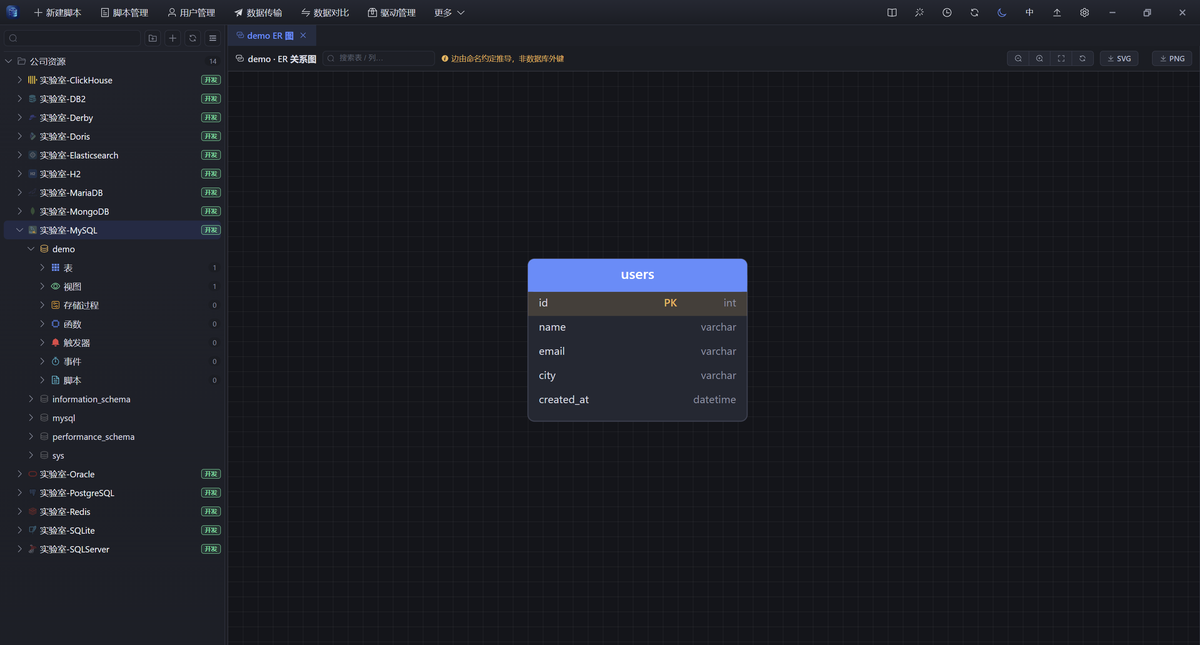
ER 关系图

用命名约定 + 真实外键推断表间关系,自动布局后可拖拽调整、滚轮缩放,一键导出 PNG / SVG 贴进设计文档。

查看文档 →
🔀

数据对比与传输

两个连接之间先比对结构与数据差异,再按向导把选中的表 / 对象传到目标库;跨环境搬数据不用再拼脚本。

查看文档 →
📊

数据透视与导出

框选即汇总(计数/求和/均值/最值)、分组下钻透视;导出 CSV / Excel / JSON / INSERT,长任务后台跑、完成系统通知。

查看文档 →
🔌

驱动与运维工具

驱动按需从 Maven 下载并显示实时进度,内网可指向私有镜像;备份还原、生成测试数据、全局对象搜索都在同一个工作台里。

查看文档 →
脚本 1 — mysql · 公司生产库 生产 PROD
编辑器
-- 模板变量:执行时填参,值按名称记忆
SELECT o.id, o.amount, c.name
FROM orders o
LEFT JOIN customer c ON o.cid = c.id
WHERE o.dt = :dt AND o.org = :org;
AI · 一句话解释
这条 JOIN 按 dt 过滤后走索引 → 关联列双方都有索引,预计扫描 1.2 万行 ✓
结果
idamountname
1001288.00杭州·张三
10021,024.50上海·李四
100366.00深圳·王五
双击单元格即可修改 → 事务提交
耗时 505 ms 共 3,175,128 条 · 异步统计,不阻塞回显 🔒 生产库:写操作二次确认

改数据的安全闭环

四个动作,把「手抖删库」挡在门外

开启事务

写语句不再自动提交,编辑器独占这条会话,改了随时反悔。

改 & 自查

双击单元格直接改,或跑 UPDATE;同一会话立即能看到结果。

回滚 或 提交

不满意一键回滚,什么都没发生;确认后提交,其他会话才可见。

全程留痕

每个事务动作进审计历史;关闭页签前还会提醒未提交的事务。

生产库保护,默认就位

连接标记为生产环境的那一刻,防线自动升起

🔒

生产保护默认开启

标注为生产的库,所有改动数据的操作(执行脚本、改表结构、编辑数据、导入/同步/还原)默认一律拦下,查询不受影响;开发 / 测试 / 未标注的库照常。确需临时改生产数据时可一键关闭。

🏷️

PROD 标记外显

页签、下拉、树全程可见,连错库这件事从源头消失。

✋

写操作二次确认

PROD 连接上的 INSERT / UPDATE / DROP 先预览影响,确认才执行。

⏱️

超时与行数预算

单语句超时、返回行数上限,误点 SELECT * 也不会拖死客户端。

📜

执行审计

执行历史带耗时与状态,事务动作全留痕,事后可追溯。

🧾

AI 发了什么,写在明面上

只发你的问题、用到的那几张表的表结构,以及每张表 1 行样例值(截到 24 字符);整表数据、结果集、连接密码与 API Key 都不发。没有中转服务器,请求从本机直连你配的模型端点。逐项看清单 →

版本

版本号从 1.0.0 起 —— 修 bug 与优化只加修订号,新增功能加小版本,不兼容的重大变更才加大版本

v2.0.10 修订版 最新 2026-11-05
  • 修复安装版里「从左侧树把对象名拖进 SQL 编辑器」没反应:桌面窗口默认把系统拖放整个接管了,网页里的拖拽事件被一并吞掉(浏览器 / 网页版一直正常)——现已关掉这层接管,安装包与网页版行为一致
  • 拖动范围覆盖表、视图、存储过程、函数、触发器:拖到编辑器松手即写入光标处,有选区则替换选区,双击仍是打开数据预览
v2.0.9 修订版 2026-11-05
  • 树里的对象可直接拖进 SQL 编辑器:按住表 / 视图 / 存储过程 / 函数 / 触发器拖到编辑器松手,名字即写入光标处(有选区则替换选区),省掉手敲拼错;双击仍是打开数据预览
  • 存储过程右键新增「执行」:自动打开脚本页签并按方言填好调用语句(MySQL 的 CALL、SQL Server 的 EXEC、Oracle 的匿名块…),参数按名字生成 :变量 占位符,执行时走模板变量弹窗取值
  • README 与文档的官网地址统一为 dbmind.top(GitHub Pages 旧地址已退役)
v2.0.8 修订版 2026-11-05
  • 顶栏新增「产品官网」入口:GitHub 图标左侧一把小 logo,深浅主题各配矢量图,点击直达 dbmind.top;旁边 GitHub 图标改跳仓库主页
  • 官网首页全面翻新:每个功能都有对应说明章节(补智能问数/脚本管理/备份还原/生成测试数据),演示窗重绘,功能卡「查看文档」直达对应小节
  • 官网基建升级:迁移 Cloudflare Pages(dbmind.top),访问与下载分流更稳
v2.0.7 修订版 2026-11-05
  • SQL 编辑器模板变量悬浮提示:悬停 :变量 直接看默认值与备注;库内变量青色、未入库橙色,执行时会不会弹窗一眼分明
  • 在线更新与官网下载智能分流:国内自动走 Gitee 镜像(服务器在国内,快得多),海外维持 GitHub;下载源现场测速、谁快用谁
  • 修复模板变量悬浮默认值重复展示(NOW() → NOW())与深色代码块背景
v2.0.6 修订版 2026-11-05
  • SQL 编辑器工具条小屏自适应:永远单行,放不下按级把按钮收成纯图标(悬浮快速显示文字、图标居中),宽度恢复自动还原
  • 顶栏菜单窄窗同款收图标
  • 问数聚焦表不再静默丢失:切页签/切技能回来选好的表还在,重选同一个库也不会清掉
v2.0.5 修订版 2026-11-04
  • 问数聚焦表不再静默丢失:切页签/切技能回来,选好的表还在;在数据源下拉里重选同一个库也不会清掉,问数不会再「明明选了表还去找 12 张」
  • 问数上下文(连接/数据库/模式)同样跨页签保留,切走再回来不用重新选
v2.0.4 修订版 2026-11-03
  • 新建数据库参数补全:SQL Server 可选排序规则,PostgreSQL 可设编码/所有者/连接上限,MySQL/MariaDB 字符集与排序规则下拉放全并支持筛选
  • 「建库语句」补全 SQL Server 的排序规则、数据/日志文件与恢复模式,普通权限登录不再显示空白
  • 修复 SQL 美化后行首 SET 把「ALTER … SET …」语句切成两段、执行报语法错的问题
v2.0.3 修订版 2026-11-03
  • 问数记录按对话合并:同一段对话里的追问不再每问刷一条记录,点开一条记录能整段回放每一轮问答;点「新对话」才另起新记录
  • AI 对话跨页签保留:切到表数据、SQL 查询等页签再切回来,对话和追问上下文原样还在;技能之间切换也不清空
  • 界面细节:问数卡片的 token 消耗脚注与对话统一同款、右对齐;生成中的停止按钮改为正红底白色方块,去掉点击后的蓝色焦点圈
v2.0.2 修订版 2026-11-03
  • 智能问数选表大幅增强:中文问题自动匹配英文表名(销售→sale、客流→passenger 等同义映射)与数据库表注释,候选表数量随问题自适应——点名只给命中的,问得宽泛多给几张
  • 修复中文问题在英文表名的库里只看到一张候选表、模型只能反问甚至编造表名的问题;现在常见销售/客流/会员类问题可以直接出答案
  • 表清单带数据库注释参与匹配,同分时优先给数据量大的表;「选表思路」会如实解释这次为什么挑这几张
v2.0.1 修订版 2026-11-03
  • 模型服务支持配置采样温度(默认 0.2,0 = 跟随服务端默认);不支持该参数的模型(如 kimi-k3)自动去掉重试,测试连接不再报 400
  • AI 生成回答时,发送按钮变成红色停止按钮,点击立即中断(对话、智能问数、深挖、数据字典、数据洞察都支持)
  • 模型配置表单排版优化:各输入框统一等宽,字段说明收进标签旁的问号提示,界面更清爽
v2.0.0 大版本 2026-11-03
  • 全新「智能问数」:用一句话查数据,五步执行过程全程可视(理解问题 → 读取表结构 → 生成查询与图表方案 → 执行查询 → 阅读结果写结论),每步展开实时分析内容、跑完自动折叠,步骤多少跟着问题走,不凑数
  • 问数自带只读护栏:生成的 SQL 先过内核只读校验才执行,写语句、多语句、注释一律拒绝;图表字段必须真出现在结果列里,对不上自动降级成数据表,宁可给表不给空白
  • 结论基于真实结果集撰写:计划阶段的空话不要,执行完把结果再喂一次模型写一句带数字的结论,界面上的每个数都能在明细表里逐格核对;数据概况由前端本地统计,不经过模型
  • 图表本地即时切换(柱状 / 折线 / 面积 / 饼图 / 环形 / 散点 / 热力 / 漏斗 / 仪表盘 / 数据表),不重新问模型;结果一键导出 CSV(带 BOM,Excel 打开中文不乱码),SQL 可一键插入编辑器继续加工
  • 支持追问与澄清:缺时间范围、口径不明时先反问不出图,回答尾部给 2~3 个自然的追问,点一下就接着查
  • 关窗确认不再虚报任务数:启动时把历史执行记录误当成"正在运行"(最多报 50 个),现在只统计真在跑的任务;确认弹窗也从一坨任务名改成一目一行的可滚动清单
v1.9.3 修订版 2026-11-02
  • MCP 多了「库」这一层:表清单 / 搜表 / 表结构可以带库名(SQL Server、PG 再带模式),设置里还能给默认连接配一个「默认库(+模式)」,AI 不用每次先列库再猜 —— 换库只在内存里做,不再往连接列表里塞一堆影子连接
  • 连接没绑定库时 MCP 直接说明原因:以前 MySQL 会「成功地」返回 0 张表,AI 据此认定这个库里没有表,转头去几百条连接里瞎猜
  • 设置页的「默认连接 / 默认库 / 模式」下拉宽度跟着内容走:打开就按名字撑开,长库名不再被截成「information_sch…」
v1.9.2 修订版 2026-11-02
  • 脚本管理打开即「合并」:默认只列到分组 / 数据源行,不再把脚本全摊开;搜索命中时会自动展开到底,不会出现「搜到了却看不见」
  • 分组行与数据源行支持整行点击展开 / 收起(原来只有那个小箭头能点,点空白处没反应),并把行左缘那条主色竖条去掉了
  • 每次打开脚本管理都会清空搜索词,上一轮的关键字不再把列表过滤住
v1.9.1 修订版 2026-11-02
  • 修复「脚本管理」里重命名 / 删除不生效:列表行的表格 id 曾被当成脚本 id 传下去,改名弹「脚本已不存在」、删除提示成功后脚本仍在 —— 现在打开、重命名、删除三条动作都按真实脚本 id 定位
  • MCP 不再把 SSH 隧道口令交给模型:「列出连接」返回里的 ssh.password / keyPassphrase 一律替换为三个星号的掩码(数据库口令本来就只写不读)—— 工具描述写的「不含口令」,现在名副其实
  • 不装 JDK 也能用 CLI / Web / MCP:内核优先采用可执行文件旁自带的 jre(与桌面版同一份,≥17 才用),不必再手设 DBMIND_JAVA;Windows 安装包也把 dbmind(CLI)、dbmind-web、dbmind-mcp 与桌面版一起装进安装目录,装完四端齐用
v1.9.0 小版本 2026-11-01
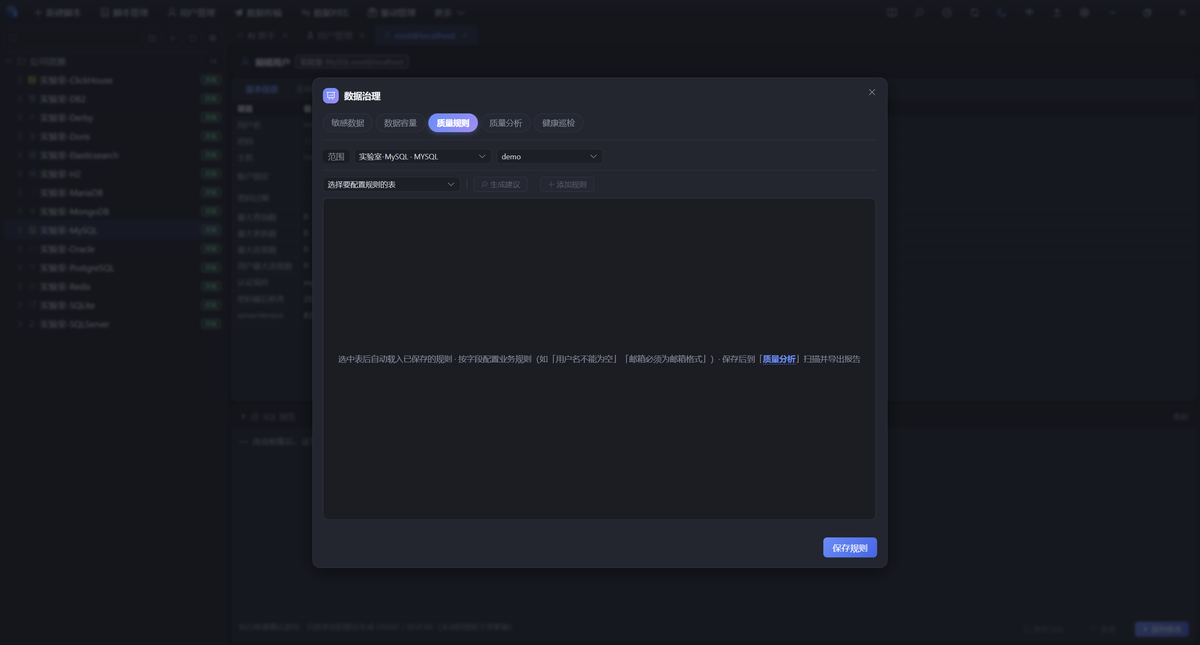
  • 字段脱敏(新):按「表 + 列」把敏感值换成 MD5 / SHA-256 摘要或 AES-256 密文(密钥存本机、可解回原文),一份规则四个开关 —— 发给 AI 的内容(上下文样例行 + 智能体只读结果)、MCP 客户端拿到的数据、结果表格的显示、导出的 CSV / Excel / JSON / SQL 文件;库里的数据一个字节都不改,表名列名注释与 SQL 里手写的字面量不脱敏
  • 结果表格右键多了「复制为 IN (...)」:选中一列直接得到 IN 参数(多列按列分段、段前标列名),字符串按目标方言转义 —— 上百个 id 不用再手工补引号
  • SQL 编辑器右键可直接「保存片段 / 插入片段 / 清空片段」:选中 SQL 命名保存到本机、跨会话保留;顶部「片段」下拉只留查看与插入(去掉重复的「存为片段」按钮),存盘失败会明说而不是静默
v1.8.2 修订版 2026-10-31
  • AI 支持多轮对话:「自主排查」以前不带上下文,说「继续」只会回「上次的对话我这边没有」并重头体检一遍 —— 现在它会接着上一轮的结论往下做;一次问两张表也不再被范围提示按回一张(聚焦表和提问里点到的表取并集,问到几张展开几张)
  • AI 更省 token:压缩内置提示词与工具说明、大库不再把 150 个表名塞进上下文、历史对话按条数与字数双预算裁剪 —— 实测同一问题修复 promptTokens 2345→956、对话 2404→1030;新增「这次请求花在哪」的零成本账本接口与日志
  • 「试跑结果」弹窗终于能显示数据:原来字段形状对不上,查询返回几百行也恒显示「执行成功,但没有返回数据 · 0 行 · 0 ms」;会话没选定默认库时会明确说明,不再伪装成「没数据」
  • 数据目录自动瘦身:开机后台回收元数据库空洞、清理过期快照与遗留临时文件(实测 805 MB → 54 MB,整个数据目录 1.5 GB → 223 MB),清空日志/缓存后当场回收
  • 问「这个库是干嘛的」不再只回一句「共 395 张表」:库级问题、以及大库里没认出具体表名的提问,改成把全库清单(表名 + 表注释)当最小上下文给模型(395 张表约 2.7k tokens,整库的列结构要几十万),能直接讲清业务;同时明确要求它「要写 SQL 先问表名」,不再照着陌生表名编字段。已经递了 SQL 的修复/解释请求仍保持精简,不塞这份清单
v1.8.1 修订版 2026-10-30
  • 弹窗里的 SQL / DDL 代码块统一成一套外观(1px 边框 + 8px 圆角 + 比弹窗底亮一档的底色),深色主题下不再是一块死黑;生成 SQL 那条 3px 主色左边条在圆角处的折角也一并去掉,两个弹窗并排看是同一个组件
  • 代码块跟着弹窗高度走:把它拉高、拖动窗口、或直接全屏,代码块都填满正文剩余高度、长语句在块内滚动(以前只有全屏才自适应,非全屏封顶 480px,拖高后下面空一大片)
  • 「复制」统一挪到弹窗右下角;建表语句、建库语句、对象详情页新增「插入编辑器」——看完 DDL 想改一改,不必再手动复制粘贴(有 SQL 页签就插到光标处,没有就新开一个脚本页签);数据视图工具栏「生成 SQL」与「重置」换位,空态提示由「点击右上」改成「点击上方」并接进中英双语
v1.8.0 小版本 2026-10-30
  • 高级搜索支持「多套条件」:组内可以选全部满足 / 任一满足,组与组之间也能选,真正拼成 (a AND b) OR (c AND d);条件改成一行一条、列名与值框上下对齐,区间条件的起止时间在同一个范围框里连选
  • 左侧树的脚本节点右键多了「查看 / 重命名 / 删除」:改名后已打开的页签标题一起改,树只刷新这个库的脚本目录(不再整棵树重载),同一库下重名会被拦下
  • 数据传输选完库自动带出默认模式(SQL Server 是 dbo、PostgreSQL 是 public),库还没选时不再显示模式;任务标题写上这一趟的对象规模(· 31 表 2 视图),同名重跑的任务能一眼区分
  • 深色主题下日期 / 时间选择面板不再整块发白:面板底、禁用日期、区间底色、时分秒列都换成了深色
v1.7.5 修订版 2026-10-30
  • 修掉例程同步的一个误判:定义以块注释(/* … */)开头的函数/存储过程会被当成「源库里没有取到该对象的定义」直接跳过,真机上一个 4.8 KB 的函数因此整条没建
  • 同步不再改掉对象名:源库里用 sp_rename 改过名的例程(目录名 test1111、定义正文仍是 CREATE PROCEDURE [test111]),过去同步到目标端会变成 test111,现在建完会改回 test1111,与源库完全一致;「删除重建」也会把上一轮按正文名留下的残留一起清掉
  • 数据传输第一步等位置的「请选择」占位与同列其他选择器对齐(连接选择器未选中时不再占用前缀位,此前偏右 4px)
v1.7.4 修订版 2026-10-30
  • 修掉 SQL Server 的 text / ntext / image 列导致目标表建不出来、整表静默漏同步的问题:这几类的长度是 2147483647 而不是 -1,此前被原样拼成 text(2147483647),建表必然报「exceeds the maximum allowed for any data type (8000)」
  • 数据传输的「失败」数改为对象级实时上报:建表失败、对象不存在这类一行都没搬的情况,任务运行中就会计数,不再等结束才跳
  • 无主键的大对象(视图、无键表)分页重做:读取页不再被「每批条数」压住,25 万行的视图单表从 936 秒降到 514 秒,事务粒度仍按每批条数
  • 超长文本类型的建表映射在各数据库间统一收敛:text / longtext / clob / varchar(max) 按目标库落成合法写法,不会再拼出带 2147483647 的长度
  • 编辑表结构:text 列不再显示长度 2147483647,类型大小写不再混排(此前同一张表里 TEXT 与 varchar 并存),SQL Server 可选类型补齐到 30 项
  • 多表对比、对象表单(索引 / 触发器 / 建表)、新建数据库、SQL 结果编辑、数据筛选、质量规则等下拉框,未选中时统一显示「请选择」
v1.7.3 修订版 2026-10-29
  • 同一个库内的数据传输改成「服务端自己搬」:MySQL 早就有的直拷通道,现在 SQL Server / PostgreSQL / Oracle / DB2 / ClickHouse / Doris 也都有了 —— 20 万行 6 列的表,SQL Server 从 239 秒降到 6 秒
  • SQL Server 跨实例同步也快了一大截(239 秒 → 35 秒):写入的预编译批此前一直是失效状态(事务保存点建不出来就静默降级),现在改用它自己的保存点语句;中等大小的表也不再退化成单连接搬运
  • 修掉 DB2「清空后导入」失败的老问题
v1.7.2 修订版 2026-10-29
  • 弹窗「全屏 / 拖大后内容只占上面一截」的一批问题修掉了:任务中心、设置、数据库转储、数据生成、连接编辑、知识库设置、SQL 试跑与执行计划、AI 优化与解释 —— 正文现在铺满弹窗、列表自己滚,底部按钮也不会被挤出屏幕
  • 设置弹窗的左右两栏改成各滚各的:以前整块一起滚,左侧菜单挤不下时也没有自己的滚动条;现在滚轮停在哪栏就只动哪栏
  • 树上每张表的行数回填提速:从「一张表一次往返」改成一批合成一条语句(95 张表 2.8 秒 → 1.8 秒),碰上大表会自动缩小批量,避免整批超时
v1.7.1 修订版 2026-10-28
  • 「编辑表结构」现在能调字段顺序:在字段表里选中一行,用工具栏的「上移 / 下移」移动,SQL 预览同步给出 ALTER 语句 —— MySQL / MariaDB / Doris 是真的改表(Doris 的分桶列会置灰并说明原因),建表后列顺序固定的库(ClickHouse / PostgreSQL / Oracle / SQL Server / DB2 / H2 / Derby)直接不显示这两个按钮,免得点了报错
  • 「类型」那一格改成可输入 + 可选择:下拉里挑也行,直接敲 character varying(64)、decimal(10,2) 这类带参数的类型也行,粘贴进去就生效、不用回车(新建表与编辑表结构同一套)
  • 新建表的 SQL 预览加了可拖动分隔条:上下拖动调高度、双击在最大与还原之间切换、点标题行收起;预览底色也和「编辑表结构」统一了
v1.7.0 小版本 2026-10-28
  • 全项目「选择连接」下拉改成「分组 → 连接」两级:组头可点开收起,打开时自动展开当前连接所在的那一组(SQL 编辑器 / 数据传输 / 数据对比 / 用户管理 / 对象清单 / 数据治理 / AI 命令面板,共用同一个组件和同一份样式)
  • 下拉里只显示连接名 —— 右侧那一列 MySQL / PostgreSQL 类型后缀全部去掉,文字统一 13px(组头原来是 12px 加粗,和成员看着不像一套)
  • 连接选择框宽度改为按选中的名称自适应(不再写死 180 / 260px),长名字不截断、短名字不留大片空白;顺带修掉「质量规则」页占位文字灰得看不清,工具栏统一到 12px
v1.6.8 修订版 2026-10-27
  • 新建表(基本信息 / 字段定义 / 索引)的字号现在跟着设置里的「数据视图表格」走 —— 以前它写死在 12~13px,索引页签还是 Element 默认的 14px,调了字号只有「编辑表结构」会变
  • 「数据视图表格」的默认字号统一为 14px:它和编辑器设置里的「结果表格字号」本来就是同一个值,以前一边默认 13、一边默认 14,点「恢复默认」后两边会对不上
  • 新建表的字段表不再一行三种字号(表头 13px / 纯文本 12px / 输入框 12px),输入框也补上字族继承 —— 不再落回浏览器的 Arial,同一字号下中文看着更小
v1.6.7 修订版 2026-10-27
  • 表清单(对象列表)里可以直接改表注释:回车或失焦即保存、Esc 还原,双击注释格或点右侧放大图标打开多行编辑框 —— 与「编辑表结构」的字段注释同一套操作和观感
  • 改注释按数据源自动选语法:MySQL / Doris / ClickHouse 走 ALTER TABLE … COMMENT / MODIFY COMMENT,SQL Server 走扩展属性,PG / Oracle / DB2 / H2 走 COMMENT ON TABLE,不会再生成对方不认的 SQL
  • Redis / MongoDB / Elasticsearch 的连接对话框现在能填用户名和密码(以前这两个框是藏起来的,开了认证的实例根本连不上),留空即按无认证连接
v1.6.6 修订版 2026-10-27
  • 鼠标在连接上稍作停留就会在后台把它连起来(SSH 隧道 + JDBC 会话),点开时几乎瞬间展开 —— 首次打开不用再等两三秒
  • 修掉树上的两个「点了没反应」:点箭头打开连接却不切换当前连接(SQL 还跑在上一条连接上);同一条连接正在连接时被当成连不上,于是既不展开也不报错
  • 更快也更省:启动时重复的请求合并成一次,catalog 探测只对 Doris 发,树重建不再重复校验刚刚确认过的连接
v1.6.5 修订版 2026-10-27
  • 换 WiFi / 断网后不用再重启 VPN:SSH 隧道的底层连接现在能发现「已经断了但两边都不知道」的半开状态(约 1 分钟),随后自动重建,SSH 与数据库连接恢复可用
  • 连接借出前的探活把「超时」也算作连接已死(以前只认「连接被拒」这类硬错误),半开链路上的死连接不会被反复复用
  • 连接级失败时先作废整条 SSH 隧道再重连(60 秒限频),避免新连接又被送进那条已经断掉的链路
v1.6.4 修订版 2026-10-27
  • 失败的对象一定给原因:读超时 / 写超时 / 探活超时 / 提交超时都会写明是哪一步、卡了多久、探活结论,不再只显示「未返回原因(详见同步日志)」
  • 失败对象的「新增/更新」不再恒为 +0:把失败前已写入目标表的行数显示出来(灰色带悬停说明),一眼看得出是压根没开始写还是写到一半断的
  • 失败原因同时写进任务日志:以前空原因连日志都不写,点「详见同步日志」也是一片空白
v1.6.3 修订版 2026-10-27
  • 同步大表提速:多列主键的游标分页改用行值比较,每页只扫本页那一段,不再每页扫几十万行(真机 58 万行的表从 68 分钟回到分钟级)
  • 修复跑超过 30 分钟的任务在任务中心变成「已中断」:它其实还在后台搬数据,只是记录被当成过期清掉了 —— 现在运行中的任务不再被回收,「停止」按钮也还在
  • 任务记录的过期时间改为按结束时刻计算:跑一小时的任务不会一收尾就查不到
v1.6.2 修订版 2026-10-26
  • 每个 SQL 编辑器标签页各用一条数据库会话:一个页面上的慢语句(加索引的 ALTER、大表 count)不再把其它页面的查询堵住 —— 原来所有页面共用一条会话,实测一条 sleep(6) 在跑时另一页的 select 1 要排队 5.8 秒
  • 语句分割修正:分号后面同一行的注释(LOCK=NONE; -- 预估 +80MB 这种尾注)算回上一条,编辑器里的语句框、语句编号和出错定位不再跨到上一行
  • 右上角「检查更新」的图标从向上箭头(看着像上传文件)换成向下取新版,检查中 / 下载中会转圈提示
v1.6.1 修订版 2026-10-26
  • 同步跑到一半断网不再把表判红:读页失败按 1/2/5/10/20/30 秒等网络回来(不再缩页空转),表级自动重连最多 5 次、退避 2/5/10/20/30 秒,网络恢复后接着跑完
  • 「删除重建 / 清空重灌」模式下重跑前会重新清空目标表,已提交过的行不再拦着自动重连(旧逻辑第二次断连就直接判失败);清表本身撞上还没恢复的链路也会继续等,而不是立刻结束
  • SSH 隧道的本地转发端口失效后自动重建(不再把没人监听的端口发给驱动,那会让「网络恢复了还是连不上」拖到 30 分钟);写失败认出是连接级错误就立刻上抛,不再逐行磨(实测 25 秒断网曾磨了 659 秒)
v1.6.0 小版本 2026-10-26
  • 桌面版「选择文件」改用系统自带的文件管理器:还原数据库选备份文件、连接 SQLite / H2(文件)/ Derby(目录)都直接弹系统对话框,不必再在页面里的目录树里逐级点
  • 系统对话框按类型过滤(.sql / .dump / .backup / .gz / .zip,.db / .sqlite / .mv.db 等)并记住上次打开的目录,选完立刻回填绝对路径
  • 浏览器打开的 Web 版保持原来的「后端列目录」浏览方式(浏览器不提供本机绝对路径),桌面版不再需要它
v1.5.6 修订版 2026-10-26
  • 表 / 视图 / 存储过程 / 函数 / 触发器 / 事件的清单页可以勾选多行一次删除:表头的全选只作用于当前筛选结果,删除前只确认一次,删完汇总「已删除 N 个」并关掉被删对象已经打开的页签
  • 批量删除的确认框只说「此操作不可恢复,确认执行?」,不再把几百个对象名撑满一屏
  • 弹窗里的日志 / 结果区改成跟着弹窗高度自适应:「备份数据库」等任务弹窗把窗口拉大或点全屏后,日志区会一起长高,不再下半截留一片空白
  • 「查看 DDL」「表索引」「建库语句」弹窗右上角的「复制」按钮不再压在全屏图标下面(标题栏按全屏按钮的位置让出了间隔)
  • 「转储 SQL 文件」「运行 SQL 文件」弹窗不再一打开按钮就是灰的:任务状态初值被写成了「运行中」,现在只有真正跑任务时才禁用;「运行 SQL 文件」执行成功后也会正常刷新左侧库节点
v1.5.5 修订版 2026-10-26
  • 「增量 / 合并 / 设了每表行数上限」的同步收尾不再比较行数、也不再清空重传目标表 —— 过去一判「不一致」就先 truncate 再灌,等于替用户删掉目标端已有的历史数据
  • 「传输数」改成只在一个地方记账(INSERT / upsert / 快速装载各记一次,引擎层不再重复累加):与「读取数」同口径,不再偏高,也不再出现读取一路涨、传输恒为 0
  • 同步读页按「实际拿回的行数」推进(读侧少给几行也不会跳过没读到的数据),DBMIND_SYNC_PAGE_ROWS 在链路抖动缩页后能自己爬回设定值;日志里写明「同时搬 N 张表(自动 / 界面设置)」,结果卡上的大数字也不再挤在一起
v1.5.4 修订版 2026-10-26
  • 不再出现「会话不存在」:根因是空闲会话探活的判断写反了 —— 探活说连接已断时反而留着死会话的 id,整库同步跑到后半程复用空闲连接时第一张表必失败;现在探不通就丢缓存、下一次直接重连
  • 万一还是撞上:宿主回「会话不存在」时自动重连并重试一次(这类错误说明语句一定没发出去,写语句也安全);链路真正中断(Communications link failure)仍然不重试
  • 点「重新同步失败对象」时读取数 / 传输数 / 失败数归零,不再挂着上一趟的 8637 万
v1.5.3 修订版 2026-10-26
  • 结果表更好找问题:失败的行自动排到最前面(失败 → 跳过 → 成功),类型 / 对象名 / 状态三列还能点表头再排
  • 说明列按内容自适应加宽(默认 200,最长 560):以前被压在 90px 左右,「会话不存在」「Duplicate entry …」全被省略号吃掉
  • 失败却没返回原因时显示「未返回原因(详见同步日志)」,不再是空白格
v1.5.2 修订版 2026-10-26
  • 传输数不再恒为 0:以前只有收尾才一次性补齐,运行中看着像「只读不写」;现在每批真落库就累加,两阶段 upsert 的更新行也计入
v1.5.1 修订版 2026-10-26
  • 同步后自检:跑完逐对象核对「有没有建出来、行数对不对」,日志直接写清哪张表、差多少行(源 917,354 / 目标 917,300,少 54),不一致的自动清空重传一次,再复检给结论
  • 不再误判:带行过滤的同步以前每次收尾都拿整表行数去比,判成不一致又白清空重传一遍;现在按同一份过滤条件核对
  • 进度不再骗人:对象数跑完但还在校验 / 重传时最多显示 99%,任务中心同样;进度卡「传输数比读取数多」也修了
  • 重传失败有原因:重传本身报错时日志会写「表 X:重传失败:…」,不再只报一个差额
v1.5.0 小版本 2026-10-26
  • 写入更快:同步到 MySQL / MariaDB 目标改走 LOAD DATA LOCAL INFILE 快通道(纯插入时自动启用),服务端不再逐行解析 SQL —— 同机实测 5~8 万行/秒,多值 INSERT 是 2~3 万;服务端没开 local_infile 这类情况自动改回 INSERT,日志里说一句,已写的行不会重写
  • 跳过目标端 binlog:勾上后写入不再为每行多写一份 binlog,写放大减半、同步更快(仅 MySQL / MariaDB 目标);目标库有从库、或靠 binlog 做同步与审计时别勾
  • 保住类型精度:结构同步不再抹平 datetime(6) / time(3) 的微秒与 decimal 的小数位(以前同步完微秒就没了),bigint unsigned 这类超过 9223372036854775807 的值不再被截成上限
  • 进度更清楚:同步进度卡加「已传输对象」,和「对象总数」并排,几百张表搬到第几张一眼看得出
v1.4.0 小版本 2026-10-25
  • 传输参数新增可调的并发三项:并发表数、每表读并发、每表写并发,都能选「自动」或指定 1~16 —— 链路差、目标库吃紧想更稳时自己降到 1,默认仍按库类型与表数自动切预算
  • 同步完成行能看出时间花在哪:「N 批,平均每批 X 秒」判断是不是每批的固定开销,「其中等待超时/重连 Y」判断是不是链路在拖;耗时改为计入整表重跑的全部轮次
  • 每批条数与两条限速改成下拉,随时能选回「自动 / 不限制」;写超时时若这一批只有几十 KB,不再缩小页(报文不是原因时缩页只会让批数翻倍、越跑越慢)
  • 同步报错只带数据库/驱动的原话:去掉「开启事务失败:」「提交事务失败:」这类前缀,这些上下文只进文件日志
  • 任务中心的同步标题:两端库名相同时压成「A → C / 库」,不再出现两个名字完全一样、分不清谁是谁的任务
v1.3.4 修订版 2026-10-25
  • 关系型连接(MySQL/MariaDB/PostgreSQL/Oracle/DB2/达梦/Kingbase/SQL Server)的并发会话上限由 4 提到 8:同步搬数据时取表结构、监控轮询不再排队 30 秒报「等待可用连接超时」(上一版的「单连接并发上限」设置项已移除,改由类型内置)
  • 同步取源表结构遇到会话排队超时改为自动重试(1 秒 / 3 秒),不再把本来正常的表判为失败
  • 同步日志的「已写 N 秒,继续等待」带上表名,多表并行时能分清是哪一张在等
v1.3.3 修订版 2026-10-25
  • 新增「并发会话上限」设置(默认 8):同步搬数据时,取表结构、监控轮询不再排满 30 秒报「等待可用连接超时」
  • 同步取源表结构遇到会话排队超时改为自动重试(1 秒 / 3 秒),不再把本来正常的表判为失败
  • 同步日志的「已写 N 秒,继续等待」带上表名,多表并行时能分清是哪一张在等
v1.3.2 修订版 2026-10-25
  • 同步日志只留真实报错:去掉「源表不存在或没有列信息」这类我们自己编的结论,断网、宿主重启、权限、表不存在都以数据库/驱动的原话出现
  • 顺便清掉自造的判定说明与调参建议(「已弃用该连接」「退回逐条提交(大表会明显变慢)」「(链路没断)」等),重试次数这类过程量只进文件日志
  • 断网重连后,元数据与写语句的失败会被认成链路级错误:自动重连并整表重跑,而不再把这张表直接判失败(那会让整个事务里已写的行一起消失)
v1.3.1 修订版 2026-10-25
  • 同步不再有自算的超时:慢语句只按界面「超时时间」判定,探活通过就一直等(Navicat / DBX 的行为),日志里给的是数据库原话,不再出现我们自造的「写入中断」「连接半开」
  • 「限速」两个输入框不再显示 0:不限制时显示「不限制」,颜色与正文一致,不再像没填
  • 同步的写会话在事务中不再被会话配额回收(以前批与批的空档可能被关掉,几万行随事务回滚、任务却算成功);万一撞上「会话不存在」,现在会自动重连并整表重跑,而不是把这张表判失败
v1.3.0 小版本 2026-10-25
  • 修复同步「漏行 + 主键冲突」:分页读源表时第一页没带排序,取到的「最后一行」并不是最大值,后面的页要么读不到(漏行)、要么把读过的行再写一遍(目标端报 Duplicate entry)—— 实测 5.8 万行的表原来只搬过去一半,现在 58,686 行一次跑完、0 失败
  • 同步对话框重做:选项收成四个页签(同步设置 / 表名映射 / 前后置 SQL / 行过滤),「同步方式」把「目标已有对象怎么处理」和「数据怎么写」合成一个选择,并新增目标表名一对一映射、行过滤条件、前后置 SQL
  • 新增同步限速:行/秒与 MB/秒分开填,0 = 不限,两条都填时取更慢的那条(生产库白天迁移可以给目标库留余量)
  • 全站功能性弹窗右上角加了「全屏 / 还原」:全屏态按 Esc 先还原不关弹窗,全屏下仍可拖右下角改尺寸,还原时回到原来的大小
  • 同步的读与写按数据源拆成插件(一种数据源两个文件,注册表由构建生成),新建数据源不再动引擎;同时补齐建表默认值的方言差异 —— Doris / SQL Server 的布尔列只认 0/1(写 false 直接语法错),MySQL 不认 CURRENT_DATE
  • 修复同步进度卡上 MB/s 恒为 0(补上读侧字节计数);一段结束时不再丢弃已经读回的下一页,同一个游标不会被读两遍
v1.2.58 修订版 2026-10-24
  • 同步设置里的「并发表数」移除:现在固定最多 2 张表同时搬 —— 每张表内部本来就有 2 路读 + 多路写,表再往上加会把目标端的连接数、行锁与 IO 争抢成倍放大(真机上「同步后期几乎每张表都卡十分钟」就是手工设成 8 张表引起的)
  • 「每批行数」改名「每批条数」,并且一批就是一次提交:填 1000 就是每 1000 条提交一次,卡住或断连最多回滚一批、重跑也只重跑这一段(实测提交次数多 100 倍,吞吐没变)
  • 慢批自愈:探活正常但一批写了 60~180 秒还没完,就回滚这一段、换连接、缩小页重试,不再干等界面上的 600 秒;一张表踩过的页上限立刻对同一任务的其它表生效,不必每张表各撞一次
  • 修复同步进度「数字越蹦越小」:状态轮询改成串行、同一任务只保留一个在途请求,运行中「读取数 / 传输数」只增不减
v1.2.57 修订版 2026-10-24
  • 「并发表数」不再显示 0:输入框直接显示实际会用的张数,按源/目标库连接能力算好 —— 嵌入式库(SQLite / H2 / Derby)1 张、Doris / Oracle / 达梦 / DB2 3 张、MySQL / MariaDB / PG / SQL Server / ClickHouse 8 张,再与已选对象数取小;想调小直接改,改了就按改的走
  • 「?」里的说明同步改成「已按源/目标库的连接能力填好默认值」
  • 到这一步,同步选项里三个数字都是「显示实际生效值、可直接改」:并发表数、每批行数、超时时间
v1.2.56 修订版 2026-10-24
  • 同步选项里只剩两个数字:「每批行数」和新增的「超时时间」—— 与 DBX 的「操作超时」对齐。超时时间可选 继承连接(默认)/ 不限制 / 30 / 60 / 120 / 300 / 600 秒;每批行数下面那段长说明已删掉,「?」缩成一句「一条 INSERT 写多少行。越小越稳,越大越快」
  • 内部所有「多久没响应算超时」都由这个旋钮决定:单条写语句、整页写入、upsert flush 直接用它;读一页夹在 30~180 秒(慢链路上的大页不再被 30 秒误判后重读);提交夹在 60~600 秒(提交失败无法自动重跑,宁可多等)
  • 选「不限制」不会再被内核的 600 秒先切断:语句超时一并跟随旋钮
  • 探活加固:探活超时从 5 秒放宽到 10 秒,并且连续两次不通才判「链路已断」—— 偶发丢一个包不再触发「回滚一段 + 换连接重跑」
  • 建索引这类 DDL 的上限从 180 秒放宽到 300 秒(千万行的表建二级索引,三分钟是常态;失败仍按「N 个索引未建」报出并可手工补)
v1.2.55 修订版 2026-10-24
  • 「每批行数」现在放到界面上(同步 → 选项),按目标库填好默认值,也可以自己改:ClickHouse 10000、PostgreSQL / Doris 2000、MySQL / MariaDB / SQL Server / Oracle / 达梦 / DB2 1000、SQLite / H2 / Derby 5000 行一条
  • 单条语句的字节上限也按库分开:ClickHouse 与本地库 8MB、MySQL / MariaDB 1MB、Doris 512KB、其余 4MB;起步仍是 512KB,实测每条语句够快就自动翻倍,慢就自动缩小
  • 宽表先被字节上限切开,Oracle / 达梦 / DB2 另受「派生表表达式 65535 个」限制(130 列时约 504 行/条),所以上面的行数是上限、不是承诺
  • 事务段从 50 万行降到 10 万行提交一次:提交开销仍是百分之一量级,但断开时要回滚的只有 10 万行,重跑快得多,也避免大事务「越写越慢」
  • 任务第一行日志会写「每批最多 N 行」,界面填的值有没有生效一眼可验
v1.2.54 修订版 2026-10-23
  • 修掉「大表前面都不报错、越到后面越报中断」:那条「传输协程 11 分钟没有任何进展」的判据是11 分钟没有一页落库,而不是总时长 —— 前面行窄的大表每页分钟级就落库,后段宽表(大字段 / JSON)一页在丢包链路上要十几分钟,于是被当成「连接已半开」判死。现在无进展到 11 分钟会先跑一次 select 1 探活:链路还通就继续等(日志写一行「N 分钟没有进度,但目标端探活正常,继续等待」),探活不通才判链路已断
  • 两处判定都改了:对象级(每张表的协程)与协程级(片内传输),不会再出现「跑着跑着突然整表报失败」
  • 真断时的文案明确写「且目标端探活不通」,不再是含糊的「连接可能已半开」;重跑该段、全任务暂停 15 秒等逻辑不变
  • 与 1.2.53 配套:单条 INSERT、整页写入、upsert flush 都已是探活式等待,慢不等于断
v1.2.53 修订版 2026-10-23
  • 整页写入不再按时间判中断:以前一批(本次任务常见 2 万行一页)写到 60~300 秒就判「连接可能已半开」,回滚这一段换连接重跑 —— 日志里反复刷的「单批 20000 行写入 100 秒未返回」就是它。现在改成每 30 秒另开会话探活一次:链路活着就继续等,只有探活不通才判链路已断
  • 真断的处理不变:弃用该连接、回滚这一段、换新连接重跑(数据会重新写入,不丢行);探活不通时整个任务暂停 15 秒,避免几百张表在同一秒各自重连
  • 语句粒度不变:一页 2 万行会按字节上限切成多条 INSERT(MySQL / MariaDB 单条上限 1MB、起步 512KB,健康链路几条语句后自动翻倍),大报文在这条链路上丢一个包就要重传几十秒,这是中断的根源
  • upsert 的更新发送(flush)同样改成探活式等待,不再到点就判「发送超时」
v1.2.52 修订版 2026-10-23
  • 写入不再因为「慢」被判成「断」:单条写语句每 20 秒另开一条会话跑 select 1 探活,链路活着就一直等(Navicat / DBX 的行为),只有探活不通才判连接已断、回滚该段换连接重跑;真断的发现速度反而更快(≤25 秒),但不会再误杀一条只是慢的语句
  • 报文先小后大:所有方言头几批从 512KB 起步,实测每条语句 1 秒内完成就自动翻倍;MySQL / MariaDB 单条 INSERT 上限从 3MB 收到 1MB —— 几 MB 的语句在公网 / VPN 链路上丢一个包就要重传几十秒,这是「写入中断」反复刷的主因
  • 之前「一张表撞到就全任务用小报文」的收敛逻辑保留:真断一次之后,同任务的后续表直接用小报文开工,不会几百张表各撞一次
  • 慢语句期间界面日志不再出现「写入中断 / 自动换连接重跑」,只有真断(探活不通)才会走到那条路径,且原因会写清「探活不通」而不是「可能半开」
v1.2.51 修订版 2026-10-23
  • 同步日志看得懂了:开始行按类型给出数量(表 / 视图 / 存储过程 / 函数 / 触发器 / 事件各多少个),不再是「其余为视图/例程」这种看不出清单的含糊说法
  • 视图与例程同步每一步都留痕:「删除目标 → 创建」各一行,视图依赖串行重试会说明有几个视图在重试,重试仍失败也会把原因打出来(原来日志停在「创建视图」,收尾却是「失败 1」)
  • 链路整体断开时不再几百张表一起重连重跑:写超时后先另开会话对目标探活(5 秒),探不通就整个任务退避 15 秒再继续;探得通才当作单条连接半开,换连接重试
  • 一张表撞出来的报文上限结论全任务共享:后面的表直接改用更小的单条 INSERT 开工,不必各自再把链路撞断一次
  • 同步收尾不再一等五分钟:超时 / 被打断的写入批不再抬高看门狗上限(真断连即刻判定),写速估计照实下调、页跟着缩小
  • 建索引这类 DDL 的墙钟上限从 600 秒收到 180 秒:慢盘上不再整段卡住任务,超时按「N 个索引未能创建(可在目标库手工补建)」报出并继续
  • 界面细节:进度卡的「对象总数」在还没数完时不再显示 -1;点「停止」后强制结束的说明简化成一句结论(细节进文件日志)
v1.2.50 修订版 2026-10-23
  • 生产保护不再把只读语句当写拦下:打开数据库、看会话(USE、会话级 SET、sp_who2、sp_helpdb、DBCC SQLPERF)照常用,真机那句「打开数据库就报生产不允许」已消除;sp_executesql、xp_cmdshell、DBCC FREEPROCCACHE 这类照旧拦
  • 表 / 视图 / 库的右键动作改用节点自己的连接:查看 DDL 不再报 Cannot read properties of null,也不会在右击别台服务器的表时把语句发到当前连接上
  • 老库能连上了:「允许旧版加密连接」补上 TLS 1.0 的客户端首选协议(SQL Server 2008/2012 那一代只讲 TLS 1.0),并且默认开启、已装库自动迁移
  • SSH 隧道新增主机公钥校验(直接读你 ~/.ssh/known_hosts);同一跳板机 + 同一目标只开一条隧道,认证一次反复复用,握手总数限流 8 条,并发同步不再撞跳板机上限整批卡死
  • VPN/链路断开再连上后,第一条语句不再必报一次 Communications link failure:只读语句在连接级失败时重连重试一次,页签里的会话也纳入保活探活
  • 同步时每张在跑的表至少 2 路读:单流只吃到链路的一半带宽,慢表不再被并发表数挤成单路拖住整库尾部
  • 一页 30 秒没回来就判定这页回不来、并把页缩到四分之一(原来等 60 秒、只减半),半开连接上不再出现一张表烧掉半小时、几万行进不动
  • 数据治理「查看错误数据」在 SQL Server 上报 'offset' 附近有语法错误:违规明细分页补上 order by (select null);同时修掉 Oracle / DB2 上违规总数恒显示「未知」,以及质量分析在 Oracle / DB2 上逐行规则全部报「取数失败」的列名大小写问题
v1.2.49 修订版 2026-10-23
  • 没主键也没唯一索引的表,现在也能「传一段、落盘一段」:中途断连只重跑当前这一小段,不再整片从头重扫(380 万行的表断一次过去要白等几十分钟)
  • 这类表的行窗口分片默认开启:不用再手动设 DBMIND_SYNC_WINDOW=1,整库 351 张表(含十几张百万级无键表)实测一次跑通、失败 0
  • 修掉无键表在分片边界越界读取导致的崩溃
  • 一页读 60 秒没回来会自动把页缩小(最低 500 行,约 80 KB),丢包链路上不再整表重跑;想固定页大小用 DBMIND_SYNC_PAGE_ROWS
  • 目标端的建表 / 清空改用一条专用连接:以前每张表各开一条,6 张表并发就把连接的并发上限占满,日志刷「等待可用连接超时」,删表重建失败后降级、灌数也跟着失败(真机整库 112 张表行数对不上)
v1.2.48 修订版 2026-10-23
  • 整库同步收尾逐表对账:源表数一遍行数、目标表再数一遍,不一致就清空重传一次 —— 「源有什么、目标就得有什么」不用再靠人盯
  • 大表先跑:按源表体积从大到小调度,不再出现「最后只剩一张大表、8 路并发退化成单流」的整库拖尾
  • 没主键的表也能快:源表上有唯一索引就拿它当翻页游标,深翻页的 O(N²) 变成「每页只扫本页」
  • 既没主键也没唯一索引的表:按行号切成多段并发拉(DBMIND_SYNC_WINDOW=1 开启),不再单流翻到底
  • 覆盖式同步按源重建目标表:字符集、长度、唯一索引全部对齐,不再一天攒出几千行「写入失败」;重建失败时退回「保留结构 + 清空灌数」并写明原因
  • 建索引合并成一条 ALTER(MySQL / MariaDB):1 亿行的表 6 个索引只扫一遍,失败再退回逐条建
  • 断连时单条 INSERT 上限自动减半(32KB 起):绕过「上行报文过 60KB 就被丢、19 秒后连接重置」的链路黑洞,健康链路不受影响
  • 幂等写入:清空后导入用幂等插入,链路断开重跑与已提交区间重叠时不再报 Duplicate entry 把行判成脏数据
  • Derby 目标端也走原生 MERGE 了:以前只能纯 insert,重跑撞主键就把行判成脏数据,是所有 JDBC 关系型库里唯一没有幂等的
  • 老连接里的 socketTimeout=0 当没填处理:半开连接不用再等 5 分钟兜底超时,也不必逐条重存连接
  • 进度数字只增不减:「传输数」不再超过「读取数」,断连重跑时也不会往回跳
v1.2.47 修订版 2026-10-22
  • 同步提速:读写不再串行——写上一页的同时并行读下一页。单表 500 万行实测 21,141 → 30,317 行/秒(+43%)
  • 慢链路再快一截:源端连接的高级参数里加 useCompression=true 开协议压缩,同一 500 万行 165s → 120s(约 4.2 万行/秒)
  • 多表并发时自动关闭预取:在途流翻倍会把丢包链路拖成整体退避(实测两表同开从 3 万掉到 7 千);单表、或收尾只剩一张表时自动打开
  • 每张表同步完打一条「耗时画像」:读/写/合计各多少秒、几路并发、页多大——瓶颈在读还是写一眼可见
  • 新增目标端写入参数检查:innodb_buffer_pool_size 过小、innodb_io_capacity 过低、flush_log_at_trx_commit=1 会在任务日志里点名,并给出建议值
  • 新增两个调优逃生阀:DBMIND_SYNC_NO_PREFETCH=1 关读预取,DBMIND_SYNC_STMT_CAP(字节)改单条 INSERT 上限
v1.2.46 修订版 2026-10-21
  • 同步提速:一页的行数不再一刀切,按实测写速与读取耗时自动调(写得快页就放大、链路丢包就缩小),慢链路上实测约 1 万 → 3 万行/秒
  • 走 SSH 隧道、跨网这类慢链路时,在连接的「附加参数」里加 useCompression=true 可开协议压缩,实测吞吐再翻约一倍
  • 整库同步跑到只剩大表时,会自动把省下的写并发让给它们(不再单路爬完最后半小时);「并发表数」的说明收进标题后的问号
  • 走 SSH 跳板机的高并发同步不再整批卡死:客户端会限制同时握手的数量(跳板机 sshd 默认超过 10 条未认证连接就随机丢弃)
  • 修复:同步中点「停止」时,队列里没写完的页会被误报成「N 行写入失败」(其实没丢数据,只是取消)
  • 修复:任务日志只留 200 行,「详见任务日志」指向的失败原因早已挤出;上限提到 2000 行
v1.2.45 修订版 2026-10-21
  • 传输/同步的连接不再「越跑越多」:每张表的会话跑完即还、按并发槽位复用 —— 连接数恒为「并发数 × 每表会话数」,不会再把全局配额顶满后互相挤掉正在用的连接(这正是「会话不存在(agent 可能已重启)」「写入连接已断」的根因),几百张表的建连次数从上千次降到几十次
  • 目标端写连接真的断了会整表重跑一次(只对事务型目标、且确认没退回逐条提交时执行,重跑前会清空该表),不再出现「已停止重试;本表剩余 20000 行未写入」
  • 一页的行数改为按写并发封顶(1 路写 2 万行):写一页回到十几秒,写队列不再长期满;「写池已等待」提示阈值 30 → 90 秒并改成「这是背压不是错误、数据不会丢」,单表在途内存降到约原来的 1/5
  • 交互更稳:页签的连接常驻不回收(切回来不必重新握手),会话配额默认 32 → 128(老配置里恰好是 32 的会自动升级),建连超时 25 → 60 秒且超时报错带上实际耗时
  • 二进制(BLOB / BYTEA)读取加了双层预算:单值 8 MiB、整页 64 MiB,超出的值降级成「长度 + 预览」,不会再被「500 行 × 8 MiB」这类结果把宿主和内核一起撑爆
v1.2.44 修订版 2026-10-21
  • 一行坏数据不再拖住整张表:写入失败从「逐行重试」改成「二分拆批定位坏行」——2 万行的批里 1 个坏值,从 2 万次往返变成约 30 次尝试,唯一的写会话不再被占住几分钟(读侧也就不会一直卡在「写池收不下新的一批」)
  • 「写池 30 秒没收下一批」这条提示改为按 30 / 60 / 120 / 300 秒退避,恢复时补一条「目标端恢复接收写入」,不再一次任务刷出上千条把真正的错误盖住
  • 这条提示现在带上下文:在途几批、最近一批多少行用了多少秒、最近一条失败样例 —— 锁等待、慢盘、坏行定位一眼能分开
  • 执行选项新增「并发表数」(0 = 自适应,上限 32):目标端是弱机、或源与目标就是同一个实例时调小它,能直接减少双方的连接与 IO 争抢
  • 会话预算日志的措辞改准:方言声明值是「单表独享时的写路数」,不是整个任务的连接上限
v1.2.43 修订版 2026-10-21
  • 备份 / 还原接进任务中心:提交就登记,可「后台运行」收起窗口,点「查看」随时接回进度;运行中关掉进度窗也不再拦着,任务照跑
  • 同步卡住会说话了:连接已断这类错误立刻报错并停止重试,不再让几千行逐行各等一次驱动超时(真机上曾磨了 48 小时)
  • 目标端写不动时每 30 秒记一条「已读 N 行 / 已写 M 行」并更新阶段提示,不再是「读取数在涨、传输数不动、日志一片安静」
  • MySQL / MariaDB 目标端的锁等待上限压到 60 秒(元数据锁默认能等一年),被锁挡住会明确报错,不再永远显示「同步中」
  • 各类型连接的默认读取超时从「永不超时」改成 600 秒:目标端把连接半开(RDS 踢连接、中间设备静默丢包)时会自己报错,不再不写也不失败
v1.2.42 修订版 2026-10-21
  • 整库同步不再把视图、存储过程排到表前面(以前会报 Table doesn't exist,视图整批建失败)
  • 进度卡的「读取 / 传输」不再显示 0(同实例直拷也计入行数,收尾再按结果表对账)
  • 多表同步更快:小表多时最多 8 张表并行(原来 4 张),无主键大表的分页从 O(N²) 降到 O(N)
  • 索引后置:新建表先灌数据、再建二级索引,百万行级的新表能再省一截时间
  • 源表的唯一索引在目标端不再被建成普通索引(唯一约束与原表保持一致)
v1.2.41 修订版 2026-10-21
  • 表注释、列注释改完不再「保存成功但界面空白」:H2 / Oracle / DB2 / SQL Server 的注释与表选项读取一并修好
  • 改字段默认值在 Derby 不再报错(只发真正变了的属性),Oracle 改主键列默认值、SQL Server 改默认值也能用了
  • 各家默认值读写统一:PostgreSQL 的 'x'::character varying、SQL Server 的 ((5)) 这类原生写法不再出现在输入框,保存时也不会被重复加引号
  • 列注释支持清空;做不了的改动(Derby 缩短长度、Doris 改默认值)在预览区直接说明原因,不用等保存后才看到报错
  • 打开 H2 表结构不再误报「改了 3 处」(INTEGER 不再被拼成 integer(32,0))
v1.2.40 修订版 2026-10-20
  • 备份导出改用多值 INSERT:20 万行的备份文件里 insert 语句从 20 万条降到 200 条,文件体积也小了一半
  • 还原提速:同一份 20 万行备份从「一个多小时」降到 20 秒;旧版本导出的「一行一条 INSERT」备份会在执行前自动合并,不用重新导出
  • 同步写入走 JDBC 预编译批处理(SQL Server / Oracle / 达梦 / H2),decimal 保留到小数点后全部位数,不再因浮点转换丢尾数
  • 同步与对比的小优化:小表对比直接在内存里做哈希(不落临时文件);upsert 对空目标表改用 limit 1 探测;分页行数按实际行宽自动调整
v1.2.39 修订版 2026-10-20
  • 编辑表结构:长度 / 精度两格不再显示「可选 / 必填 / 精度」这类提示,所有数据库、新建表与编辑表结构两个页面完全一致;「项目 / 值」与表头统一字体字号(表头只加粗),新建表的「复制 SQL / 执行创建」统一到底部
  • ClickHouse 引擎下拉直接给出可落进 SQL 的完整写法(MergeTree() 带括号、Log 不带,并补全 Replicated 系列),新建表与编辑表结构共用同一份清单,生成 SQL 时不再按名字猜着补括号
  • 「索引类型」真正落进 SQL:MySQL 的 FULLTEXT / SPATIAL / USING HASH、Doris 的 USING、Oracle 的 BITMAP、SQL Server 的 CLUSTERED;没有索引类型概念的库(SQLite / H2 / Derby / DB2)不再显示这一列
  • 修复无分号拆分把建表末尾的 COMMENT 切成两条语句(ClickHouse 会报 failed at position 1),MySQL 的 COMMENT='…' 表选项同办
v1.2.38 修订版 2026-10-20
  • 多列排序:直接点表头的排序箭头就能按多列排序(同一列再点:升序 → 降序 → 移出),表头图标旁标出优先级 1/2/3,底栏同步显示排序链「A ↑ → B ↓」,可单列移除或一键取消 —— 不用再按住 Shift
  • 表数据预览的多列排序交给后端 order by a asc, b desc(方向走白名单,脏参数进不了 SQL);SQL 结果与 NoSQL 文档在内存里按同一套比较器排序,三张网格口径一致
  • 新建索引时名称先留空,选完「包含字段」再按 表名_字段名_idx 自动生成(与结构编辑器一致),输入框补了占位提示
  • 表头类型图标下移 1px,与字段名基线对齐
v1.2.37 修订版 2026-10-20
  • 表结构编辑器:修「只改自增列」(比如给 id 加个注释)或重建主键后点「保存修改」直接报 1054 —— 同一条 ALTER 里把同一列改了两次,现在只改一次;自增列的主键勾选框随之锁定,鼠标悬停能看到原因
  • 自动索引名:统一按「<表名>_<字段名>_idx」拼(结构编辑器与新建表一致),选完「包含字段」名字跟着变
  • 勾选框:选中态一律主题蓝,只读或锁定的格子也一样(例如自增列的主键),不再"明明勾上了却看不出选中"
  • 结果表格按字段类型对齐:数字与日期靠右、布尔居中、文本靠左;排序箭头常显并提亮,表头文字与分隔线做光学居中
v1.2.36 修订版 2026-10-20
  • SQL 编辑器:BEGIN TRAN / BEGIN IMMEDIATE 不再把后面的语句吞成一条,MySQL 行首 # 注释 正确识别(里面的分号不切语句),中文表名也能进「编辑目标表」下拉
  • 只读连接:CTE 里用换行或 Tab 藏着的写语句、SELECT ... INTO、nextval / setval 这类会改序列的 SELECT 现在一律拦下
  • 事务:带着未提交修改的连接不再被后台空闲回收,连接失联时直接报错而不是静默重连(以前会连带把事务丢掉)
  • 取消:多语句批次在语句之间就响应,长脚本点「取消」不用等当前语句跑完
  • 结果集就地编辑:标识符按各库规范加引号(中文列名、保留字不再报错),字符串按方言转义(MySQL / ClickHouse 里的反斜杠不再被吃掉)
v1.2.35 修订版 2026-10-19
  • SQL 编辑器:不写分号也能正确识别多条语句,光标所在语句有框线、点「执行」只执行这一段;存储过程、触发器、CTE、PG 美元引号函数等复杂 SQL 不再被切错
  • SQL 格式化:语句之间的空行严格按设置生效(有没有分号都一样),多条语句逐条格式化,注释与分号不丢
  • 连接与导入:重新展开已打开的连接前会先校验,连不上立即提示并收起;文件导入按目标列类型写值(Derby 数值列不再失败),Derby 表可重命名;Oracle / DM 的搜索与 ER 图按模式查询,不再枚举全部模式
v1.2.34 修订版 2026-10-19
  • 新建 / 编辑数据源表单统一:必填字段带星号,可留空的在输入框里标「可选」,不用再猜
  • 连接超时默认 10 秒、读取超时默认不限,所有数据库一致;相关提示统一并缩短
  • Oracle:「连接方式」挪到服务名上方,默认服务名,标题跟随选择显示服务名 / SID,并去掉多余的必填占位提示
  • SQL Server 去掉「实例名」,统一填主机与端口(命名实例填它实际监听的端口)
  • 空库名的 JDBC URL 更干净:MySQL / Doris / ClickHouse 不再拖尾斜杠,PostgreSQL / Kingbase 保留(驱动语法要求)
v1.2.33 修订版 2026-10-18
  • 用户管理页改版:拆成「用户管理 / 角色管理」两个页签,角色可以新建、删除,并直接以角色为主体授权;没有角色概念或版本不支持角色的库(SQL Server、SQLite、MySQL 5.7 等)只显示「用户管理」
  • 角色的权限读回补齐:MariaDB 的角色改读 SHOW GRANTS(信息架构视图不列角色),PostgreSQL / KingbaseES 从 ACL 与 pg_auth_members 解出权限和成员关系(能回显也能撤销),MySQL 角色以「名字@主机」打开不再报「没有找到用户」
  • Oracle / 达梦不再显示「库」这一层:对象列表、SQL 编辑器、对比 / 同步 / 备份、ER 图、监控与 AI 面板里的服务名与库下拉一并去掉,只留模式;顺带修好 Oracle 的模式下拉恒为「无数据」
  • 修好 Oracle 点开表看不到字段(ORA-17027):列信息改在切到目标模式后按驱动要求读取(COLUMN_DEF 先读),达梦不受影响
  • NoSQL 的占位库 (default) 在 SQL 编辑器里显示为「默认」
v1.2.32 修订版 2026-10-16
  • 多段脚本执行(「执行全部」)大幅提速:每段只取当前页的行数,不再把整表拉回来 —— 52 万行的表跑两段由十几秒降到一秒内
  • 新增 Ctrl+N 新建脚本,键位可在「设置 → 快捷键 → 通用」里改
  • 「执行全部」按钮补上 ▶▶ 图标,一眼区分「执行当前」与「执行全部」
  • 光标所在语句的框线改为无底色虚线:只划范围、不染底色,长语句不再像被荧光笔涂过
  • 修好框线的两处判定:光标停在末条语句之后的空行、或文首空行上时框线不再消失(语句末尾的分号此前被算进了「间隔」里)
v1.2.31 修订版 2026-10-16
  • 新增「对象清单」页:双击树上的表/视图/存储过程/函数/触发器/事件/脚本类别,一屏列出该类别的全部对象,行内直接查看数据、结构、DDL、编辑
  • 视图、存储过程、函数、触发器、事件、脚本都可以在清单页直接删除(与树上右键同一套确认框和只读/生产连接闸门,只多了一个入口)
  • ClickHouse 与 Doris 的表清单修好:CH 的引擎、排序键、分区键、注释原来全是空的(一条元数据 SQL 查了不存在的列,整条报错),Doris 的创建时间原来恒空
  • 各数据源的清单列改成「拿得到什么就摆什么」:拿不到值的列不再显示(SQLite/Derby 没有表注释、非 MySQL 的例程没有安全模式等属性、Doris 的引擎/字符集是无含义占位)
  • 清单页排版与表数据页对齐:表头不加粗、四周留白一致,列多到横向滚动时操作列固定在最右;顺手修掉两处显示问题(MySQL 视图的「注释」列显示成 VIEW、引擎 MergeTree 显示成 Merge ree)
v1.2.30 修订版 2026-10-16
  • 用户管理权限矩阵全面增强:所有数据库、所有权限项的列头都带中文小字说明(含 ClickHouse 全套权限、各外部数据源、SQL Server ANY 系列),不用再猜英文权限名
  • ClickHouse 用户支持表/视图级授权:新增「表权限」页签,选库选表勾权限即可生成 GRANT … ON 库.表;数据库权限的分组计数分母不再显示 0
  • 权限列头小字从 10px 放大到 11px,更易读;动态出现的未知权限名也有兜底说明(动词 + 名词自动组词)
  • MySQL 5.7 兼容:服务器是 5.7 时自动隐藏 CREATE ROLE / DROP ROLE(8.0 才有,勾上保存必报 1064 语法错)
  • 修复编辑表结构 / 树展开等元数据调用在首次之后无限排队、30 秒超时的问题(内嵌 agent 的会话锁泄漏)
v1.2.29 修订版 2026-10-15
  • 深色主题下,只读 / 生产的常驻提示条不再是一条刺眼的亮黄带:配色改为分主题取值(深色下融进底色的低透明度 + 亮字,浅色主题维持原来的浅黄底深字),用户管理页与编辑表结构页同时生效
  • 用户管理彻底连接级化:清单、表单、删除不再带着树里选中的库名 —— 修一个真机报错(树里选着 Oracle 的库、下拉切到 MySQL,请求还带着那个库名,报 Unknown database 'free.system');同时树里选中数据源(连接节点)就能打开对应的用户管理,不需要选到数据库层级
  • 一批「长任务」不再与用户的元数据请求挤同一条数据库连接:导出、备份、数据传输、数据对比、AI 试跑、质量巡检、治理扫描、行数回填现在各走独立连接 —— 树里多库展开或跑大任务时,编辑表结构 / 树展开不再排在几十条重查询后面转半天,然后报 30 秒超时
v1.2.28 修订版 2026-10-15
  • 修一个我自己引入的回归:处理 Oracle 的问题时加的「元数据预热」忘了只给 Oracle,所有数据库的每个新会话都在付这笔账(跨库找一张不存在的表)—— 树展开一次要建几十个会话,表现出来就是「所有库展开都变慢、编辑表结构转半天」。现在预热只在 Oracle 上做
  • ClickHouse 的建连从 2.4 秒回到 0.1 秒级:驱动默认走的 Apache HttpClient 路径在 Windows 上每次建连固定多 2 秒以上,换成驱动自带的 URLConnection 路径(实测取列 2.9 秒 → 0.2 秒)
  • 编辑表结构页也挂上只读 / 生产环境的常驻提示条(与用户管理页同一形态):只读连接或标注为生产的库,进页面就知道保存会被拦下,而不是改完点「保存修改」才被拒
v1.2.27 修订版 2026-10-15
  • 用户与权限整体重做:用户管理移到顶部(连接级页面),界面与「编辑表结构」统一(上方页签、下方 SQL 预览);权限改成矩阵表——权限项当列、横向滚动;授权只出差量,取消勾选只发这一条 REVOKE,不再整份重发
  • Oracle 用户可新建 / 改密 / 删除,并按「系统权限 / 角色 / 对象权限」三层授权;SQL Server 的系统权限、服务器角色、数据库角色、对象权限四层都能真正落库
  • 写入前先拦:只读连接与标注为生产环境的库,新增 / 删除 / 保存点下去就被拦下并在页面顶部常驻提示(以前是填完表单才被后端拒绝);达梦这类只支持查看用户的数据源,表单直接是只读的
  • Oracle 一批必修:支持「模式」层(不再多出一层多余的「库」)、树上的「视图」不再恒为空、例程与触发器计数不再恒为 0、首次读列从 30 秒降到 4 秒上下;改名类操作按各家方言走(Oracle 用 RENAME、ClickHouse 用 RENAME TABLE),取对象定义与编辑表结构几个必报错的操作也修好了
  • PostgreSQL / KingbaseES 的用户详情以前打不开(详情查询里的字符串拼接与判空函数是从 SQL Server 抄来的),现在能正常查看;元数据清单去掉 5000 条的人为上限(撞上引擎硬顶时树上显示 5000+,不再装作完整),打开数据库会后台预热最近用过的连接
v1.2.26 修订版 2026-10-13
  • 在线更新:安装包只留最新的一版,旧版本自动清掉(以前升一版就多留一份在下载目录里)
  • 备份与还原:上传大备份改为边收边写(不再整块进内存),中途失败或取消不再留下半截文件;命令行备份/还原点「取消」真能停掉进程(以前界面显示已取消,mysqldump 还在后台跑完)
  • 导入与导出:xlsx 内部条目超限会明确报错(以前会把整张表的文本单元格静默变空);导出的文件名在 Windows 上也规避了结尾的点/空格与 CON、NUL 这类保留名
v1.2.25 修订版 2026-10-13
  • 数据视图的字号终于全跟设置走了:首页卡片文字(之前怎么调都不动)、表数据 / NoSQL / SQL 结果三处表格的整页字号(表格、底栏耗时与总条数、分页、工具条一起变),底栏「N 条/页」的文字色也压到与旁边同一档
  • 「每页条数」在设置页与三个数据表格里共用同一套选项(最大 100000)—— 原来四处各写一套,表格那边只到 10000
  • 一轮前后端巡检修复:备份下载改流式(大 dump 不再吃光内存)、备份与还原的子进程可被取消(取消会连子进程一起杀掉)、SQL Server 建库名与同步/对比的表名按方言加引号(保留字表名不再语法错)、导出中关掉 SQL 页签不再残留任务、切换知识库或比对表时列清单不再串数据、刷新失败不再误报成功
v1.2.24 修订版 2026-10-13
  • 在线更新:安装只问一次(原来在下载完与开装前各问一次,连按两次回车就会「没打招呼地重启」),并写清"会关闭 DBmind、装好后自动打开新版";启动检查时还会清理「下载」目录里不高于当前版本的历史安装包(只删本应用下载的那些;比当前版本新的保留,免得安装没生效时连自救的包也没了)
  • 界面尺寸设置真正生效:修好「首页卡片文字」怎么调都不动(被样式表里写死的字号盖住),以及"改完再打开又变回去"(编辑器设置的加载把旧值反向覆盖回来)
  • 「数据视图表格」扩到表数据 / NoSQL / SQL 结果三处,并改成整页跟随——表格、底栏耗时与总条数、分页、工具条一起变
v1.2.23 修订版 2026-10-13
  • 在线更新:点下去先说明正在检测下载源(不再长时间停在 0 B / 0 B),真正开始下载后才显示已下载大小、速度与预计剩余时间
  • 设置页:「恢复默认」放在离它管的设置最近的地方(页级设置与保存同一排、快捷键在卡片右上、日志紧跟日志级别),并统一成带边框的按钮
  • 精简一批提示:关闭窗口只问「退出应用,还是最小化到托盘?」,更新提示按钮改为「不再提示此版本」,去掉几处多余的说明文字
v1.2.22 修订版 2026-10-13
  • 只读 / 生产库的写操作,点击那一刻就拦下:导入数据、数据生成、清空表、截断表、删除表 / 删除对象、重命名 —— 连接是只读、或标了生产且开着「生产库保护」时,点下去直接拦下,连弹窗都不打开。以前要把整个流程走完、提交那一刻才被拒("选完文件、传完才被告知不许导")
  • 拦截提示统一在右上角,并且能直接去改:这类提示全部走右上角通知(不再在中间再蹦一条重复的红字);只读那条带一个「去修改数据源 →」按钮,点开就是这个数据源的编辑弹窗、并停在「高级 → 只读」那一项上高亮一下;生产保护那条直达「设置 → 安全与会话」。同一条通知在结构页、数据编辑、SQL 编辑器、重命名弹窗等处表现一致
  • 树上悬停看表注释:悬停表 / 视图即可看注释(原先没有入口),卡片贴在行的右侧树外(不被树容器裁切)、宽度按内容自适应、外观与连接悬浮卡同款(含小三角尖)
  • 连接名后的角标统一了,并按主题取色:环境(开发 / 测试 / 生产 / 预发 / UAT)与「只读」以前各写一套尺寸与字重、浓淡也不同;现在完全同一套(10px / 600 / 高 15 / 圆角 4 / 同款边框)。颜色随主题走 —— 浅色主题下这几个颜色都换成了看得清的深一档(原先「测试」的琥珀在白底上几乎看不清),深色主题保持原来的鲜艳色
  • 首页与树上的一批体验修复:查询趋势改为按天聚合(不再把同一天拆成多根柱子);空表显示 0 而不是一片空白,并修掉大库一次性 COUNT 导致的长时间不出数(改为分批回填,三百多张表也能很快看到前几批);删除类图标全项目统一成红色;表结构预览的两处提示合并为一条
  • 一轮前后端体检:修掉 1 处功能损坏、2 处「静默假成功 / 丢数据」、4 处串数据(不同表 / 库之间的状态互相污染),以及发版脚本的错位问题
v1.2.21 修订版 2026-10-13
  • mac 在线更新后自动打开是白屏:修掉了根因 —— 更新后重启的实例只要端口上"有人应答"就直接复用那个内核,既不比对版本、也不确认它那一刻还活着;而更新脚本恰好同时把旧内核关掉,于是窗口指向了一个已经没人监听的端口(macOS 的 WebView 加载失败时什么都不画,Windows 会画一张错误页,所以只有 mac 表现为纯白)。现在复用前先比对版本、并确认确实可用,不可用就自己起一个内核;顺带修掉 mac/Linux 上残留内核清不掉(进程名写死 .exe)与启动就绪超时没有任何日志(新增 ~/.dbmind/logs/shell.log)
  • mac 更新安装更稳:应用若是在镜像窗口里直接运行(没拖进「应用程序」),不再尝试原地覆盖 —— 那等于往只读卷写,就算侥幸成功也没意义(下次还从那位置启动);覆盖后会校验前端资源确实落地再重启;并修掉"更新完软件像是没了"(兜底打开的是已被删除的安装镜像)
  • 「关于」页版本说明:修折叠头的「当前版本」不跟着发版走(仍显示上一版号);修版本要点超过 12 条时后面的永远不显示(v1.2.20 有 14 条);清理词典里 99 个重复键(同一版本存在两套要点)
  • 官网版本页与关于页的文案:同步脚本现在会直接发布官网(不再只是提示 —— "改好源文件 ≠ 线上更新"已经漏过两次);发布前先对齐远端分支,避免本地落后时永远推不上去;网页与关于页不再出现字面 与反引号(markdown 装饰泄漏)
v1.2.20 修订版 2026-10-13
  • 「编辑表结构」在非默认模式下看不到字段的问题修好了 —— PostgreSQL / SQL Server / 人大金仓这类带「模式」的库,树上按「库.模式」取对象,但取"字段"那一路一直只认连接的默认模式(PG 是 public、SQL Server 是 dbo),于是别的模式下的表就成了「能列出表、字段却是空的」。现在整条链路(字段 / 建表语句 / 索引 / 注释 / 类型补全)都按你点的那个模式取
  • 取不到列不再静默给空:Doris 的元数据取不到时会以前如实返回「没有字段」,让人以为表坏了;现在明确报出原因(当前库不对 / 表不存在 / 没有 information_schema 读权限)
  • 大树不再卡:库里上千张表时,展开先出前 200 行、剩下的在后台自己长全(列表始终是完整平铺的,中间没有「显示更多」);鼠标扫过连接节点也不再让整棵树重绘
  • 数据传输:修 MySQL 目标建表报 Row size too large (8126)(两处类型映射偏胖 + 显式 DYNAMIC 行格式 + 报错给出列规模);写入侧并发与批事务调优,大表更快
  • 数据传输 → 选择对象:类型徽标改成筛选器 —— 点「表」只显示表、点「视图」只显示视图,再点一次回到全部;切类型时已勾选的对象不会再丢
  • 数据对比 / 数据传输:修「库不预选」;数据库右键菜单新增「数据对比」「数据传输」,并自动选中右击的那个库
  • 列类型写法统一:同一个类型「下拉里一种写法、回显另一种写法」的问题修掉了(MySQL 回 VARCHAR、Doris 回 STRING、PG 回 varchar…),按各库自身元数据的写法对齐
  • 新建表 / 编辑表结构:修打开「字段定义」报错;修列数超过 80 时点删除会删错行;类型格字号与同排其它列一致
  • 左侧树的右键菜单:点菜单里的按钮、或点其它任何地方,菜单都会关闭(以前会留在那儿挡操作)
  • SQL 编辑器:点结果页签自动选中对应的那条语句(与顶部语句页签一致);语句面包屑与定位改以编辑器自身文本为准(修注释掉首条后编号与结果错位、点结果跳错语句)
  • 连接悬浮信息卡:不再挡住列表与点击,竖直居中、带指向连接的小箭头、字号与其它处一致
  • 分组可以置顶:分组右键新增「置顶分组」,顺序随设置保存
  • 设置:界面尺寸新增多项(首页卡片 / 弹窗标题与正文 / 数据视图表格 / 消息提示 / TAB 栏文字),SQL 格式化页与界面尺寸页的排布重排
  • 一批稳定性修复:设置页每次打开都会因一个不存在的函数中断后续加载(驱动列表 / 通知 / 知识库 / 快捷键因此是空的)、词典缺键与重复键、定时器在页面重挂后叠加、切表时字段可能串到另一张表、可增删列表的行状态串位、后台读取协程异常时不再误报「成功」
v1.2.19 修订版 2026-10-12
  • 表预览的总条数修对了 —— ClickHouse 的 count(*) 返回的是浮点,此前取不出来,于是底部显示「共 200 条」(本页行数)、还翻不动页;现在显示真实条数并可翻页,各数据源一并修正
  • 「数据治理 → 容量统计」的行数同样修正:ClickHouse 下不再恒为 0 或显示「未知」
  • 设置 → 通用 → 界面尺寸新增「TAB 栏文字(工作区页签)」:工作区那排页签(如「脚本 1 ×」)的字号从此跟随设置,改完立即生效、不需要重启
v1.2.18 修订版 2026-10-12
  • 编辑表结构:加载期间终于有「加载中」提示了(v-loading 指令此前从未注册,写法上被静默失效),转圈样式也不再卡顿
  • 字段表(编辑表结构与新建表):只渲染看得见的行 —— 几百列的大表滚动跟手、不再冒白块;「类型」格平时是纯文本,点一下才展开下拉选择
  • 顺手修掉几处小毛病:字段表选中态只剩一种样式(首行不再看起来像被选中)、注释格输入框底色与旁边一致、字段表头不再夹带 SQL 英文、在线更新的确认框改成「说明在前、问句在后」并去掉「打开所在文件夹」按钮
v1.2.17 修订版 2026-10-12
  • 表结构编辑器:新建表与编辑表都只显示该数据源真正适用的列;Doris 的字段表可以直接勾「分桶列」,与基本信息里的分布列是同一份数据(勾哪边另一边立刻跟着变,建表语句也是同一份);ClickHouse 补上「分区键」列,并把一直藏着的主键列显示出来 —— 至此每个数据源里"列能参与的表级设置"都能在字段表里直接勾
  • 编辑表结构:修好「排序键 / 分区键」的回显(此前无论表里怎么设,字段列表里永远显示「—」);新增只读的「分桶列」「分区键」两列;是/否 一律只用勾选框(可为空、主键、排序键、分桶列、分区键)—— 全数据源一个样子,不再出现「是」标签与破折号
  • 新建表:字段「注释」支持双击或点按钮打开多行编辑框(与编辑表一致);数据源修复 —— 达梦与 H2 的列注释此前读不到(注释格永远是空的)、达梦不再显示一个永远勾不上的自增勾选框、MySQL 的 DEFAULT NULL 正确回显成「默认 NULL」;顺带去掉字段表头里夹带的 SQL 英文(分桶列 / 排序键 / 分区键),在线更新去掉「打开所在文件夹」按钮
v1.2.16 修订版 2026-10-11
  • 在线更新:包已经下好时,点顶栏图标(或启动检查)直接给「现在更新」,不再先弹一遍版本说明;本机已有完整安装包也不会重下一遍,重启过照样认得
  • 在线更新:过程提示全部去掉 —— 「第 N 次重试」「从已下载的 X 继续」「正在选择下载源」这些都不再出现,只剩进度与速度那一行
  • 在线更新:「换个更快的源」现在真的会换(先取消、重新测速排源、再从断点接着下);失败可原地重试,后台下完或失败都会主动弹框,安装成功后自动删掉安装包
  • 在线更新的两个弹窗与其它弹窗统一(标题带徽标、按钮同规格),确认框改成「说明在前、问句在后」
  • 首页「快速开始」的连接名字字号与右列「常用操作」拉平
v1.2.15 修订版 2026-10-11
  • 在线更新:点「在线更新」前会先说清「应用会自动关闭,装好后自动打开成新版」,不再突然消失
  • 修 macOS 升级后不自动打开:装不上时不再无声中止 —— 会弹出镜像让你拖进「应用程序」;重开也改成自动重试
  • 「检查更新」弹窗只讲更新了什么:不再把发行版里的「安装包」表格一起显示出来
  • 下载进度条改细,不再显得笨重
  • 顶栏的语言钮(中 / EN)不再加粗,和旁边的图标一样重
v1.2.14 修订版 2026-10-11
  • 「结果表格字号」现在带动整块结果区:表头、底栏(耗时 / 总计 / 选中汇总)与分页器一起随字号变化
  • 分页器的「200 条/页」与跳页输入框也一并跟随 —— 不再出现表格字变大、旁边的字还是小字
v1.2.13 修订版 2026-10-11
  • SQL 格式化新增两处可配项:「逗号位置」(字段后 / 字段前)与「缩进风格」(标准 / 表格左对齐 / 表格右对齐)
  • 「关键字排版规则」新增「缩进宽度」列:可对每个关键字单独配,留空跟随全局,填 0 表示不缩进
  • 编辑器右键菜单新增「编辑器设置 / 格式化设置」,点一下直达对应设置页
  • 设置面板观感优化:规则改成带边框的表格,控件对齐与字号和其它设置页统一
  • 「通用」新增界面尺寸:可调顶栏菜单文字(含前面的图标)、顶栏右侧图标与左侧树文字大小,改完立即生效
  • 设置项归置:「主题」与「通知」两页并进「通用」(都属于全局界面与行为偏好),设置菜单更短
  • 修复「脚本页签偶发一片空白」:Monaco 加载失败后不再被永久缓存,并给出可操作提示
v1.2.12 修订版 2026-10-11
  • 关闭询问修好了:点「关闭」或「最小化到托盘」不再没反应
  • 在线更新改成一键静默升级:点一次就自动下载、安装、重启成新版,不再弹安装向导
  • macOS 更新后不再需要手动放行
v1.2.11 修订版 2026-10-11
  • 修好在线更新:Windows 不再报「找不到文件」,macOS 能正常打开安装镜像
  • 更新完成时显示安装包保存在哪,可手动双击安装
  • 安装包没成功落地时会说清原因
v1.2.10 修订版 2026-10-11
  • 关闭窗口前先问一句:退出,还是最小化到托盘(三个系统一致)
  • 新增托盘图标:点一下把窗口叫回来,右键可退出
  • 打包流水线提速(后续版本发布更快)
v1.2.9 修订版 2026-10-11
  • 在线更新不再问你装到哪:安装包固定存到系统「下载」目录
  • Windows 更新不再停在「已安装」页:原地覆盖,装完自动打开新版
  • 页签只显示表名 / 对象名,连接与库名收进悬浮提示
v1.2.8 修订版 2026-10-11
  • 在线更新按系统挑安装包:macOS 拿 dmg、Linux 拿 deb、Windows 拿 setup.exe
  • NoSQL 预览与结果表格对齐规则统一,NULL 跟着同列真值对齐
  • 深色模式下「有未保存的修改」提示条不再过亮
  • macOS 安装窗口居中,说明书那行文件名不再被裁掉
v1.2.7 修订版 2026-10-11
  • macOS 安装包里多了一份「首次打开请看这里」,写清三步放行
  • 两条完全不弹提示的安装方式:curl 下载、Homebrew --no-quarantine
v1.2.6 修订版 2026-10-11
  • macOS 窗口形态定稿:红绿灯与菜单同一行
  • 全屏时左上角不再空一块
v1.2.5 修订版 2026-10-11
  • macOS 窗口交回系统管理,红绿灯回到正常位置
  • 全屏不再留白
v1.2.4 修订版 2026-10-11
  • macOS 安装镜像改成两个大图标,拖一下就能装
  • 恢复系统红绿灯,修掉「没有标题栏也关不掉」
v1.2.3 修订版 2026-10-11
  • 重做 macOS 安装界面:正经的「拖进应用程序」(App 代码未动)
v1.2.2 修订版 2026-10-11
  • 修掉 macOS 打开一片黑:打包进去的资源没找到
  • macOS 安装界面重做
v1.2.1 修订版 2026-10-10
  • 修掉 macOS 双击打不开:不再依赖系统里没有的库
  • macOS 图标按 Apple 规范重做
v1.2.0 小版本 2026-10-10
  • 驱动下载不用再挑镜像:自动在国内几个源之间试
  • 宽表横向滚动更流畅(只渲染可见列)
  • 表头更清晰,光标统一成手型
v1.1.1 修订版 2026-10-10
  • 修掉三个表格编辑问题(空格被改成 NULL、双击后光标跑位、改回原样仍显示未保存)
  • 修掉一处会让界面卡死的崩溃
  • 大表滚动更流畅;结果表格默认行高 22 → 26
v1.1.0 小版本 2026-10-10
  • 不开代理也能更新:直连不通自动走国内镜像,并用官方校验值核对完整性
  • 断网或切换网络后能接着下,失败可直接重试
  • 驱动管理独立入口:装没装、缺哪些、换源、手动上传都在一页
  • 生产库保护默认开启:改数据的操作默认拦下(查询不受影响)
  • 下载源自动测速选最快,显示速度与剩余时间
  • 结果表格框选数字格恢复求和 / 均值 / 最值;外部链接改为系统浏览器打开
  • 结果表格滚动不再闪白条
v1.0.4 修订 2026-10-09
  • 卡住的传输任务不再「悄悄挂住」:超时会结束,并说清卡在哪
  • 兜底:30 分钟自动结束,日志记下停在哪一步
v1.0.3 修订 2026-10-09
  • 修掉 ClickHouse 大表「执行失败」和「读取布尔值失败」
  • 总数不再显示 -1
  • 选中 SQL 点「格式化」不再报错
  • 关键字「前换行」不再多断一行
v1.0.2 修订 2026-10-07
  • 配了代理也能下载更新(自动识别系统代理)
  • 下载可放后台,顶栏图标显示进度
  • 更新说明排版修复;「关于」页版本号与安装包一致
  • 修掉 Doris 连不上、启动与连接时闪黑窗
  • 首页恢复 KPI(总连接数 / 已连接数 / 连接类型);驱动下载显示实时进度
v1.0.1 修订 2026-10-06
  • 审计日志:按类别筛选、一键复制 SQL,条数与页数准确
  • 日志不再自动清理,只在你点「清空日志」时清空
  • 设置界面细节修复(弹窗高度、列表内滚动、分页常驻)
  • 「关于」页新增目录说明
v1.0.0 正式版 2026-09-28
  • AI 加持:SQL 解释 / 优化建议 / 报错修复 / 性能诊断 / 智能问答
  • 一个工作台管住 17+ 种数据源(MySQL / PostgreSQL / Oracle / SQL Server / ClickHouse / Doris / Redis / MongoDB / ES / 达梦 / 人大金仓 等)
  • 事务模式与结果集直接编辑:改完可自查、可回滚
  • 智能 SQL 编辑器与超大结果集:上千万行的表也能一秒见数

什么是 DBmind?

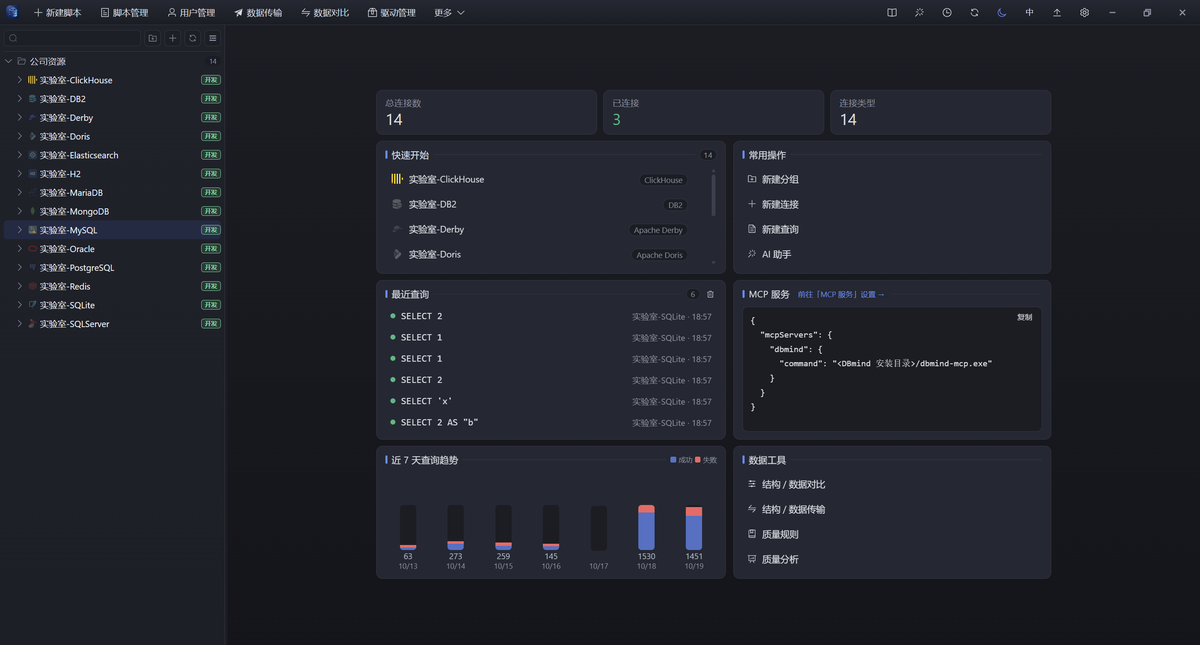
首页:左侧连接树、右侧脚本页签,一个窗口管完所有库

DBmind = Database + Mind:给数据库装上「大脑」的统一管理工作台。它把连接管理、SQL 编辑、数据表格、AI 助手、事务与安全护栏放进同一个客户端,开箱即用。

DBmind 不绑定某一种数据库:MySQL、PostgreSQL、Oracle、SQL Server、ClickHouse、Redis、MongoDB、达梦、人大金仓等 17+ 种数据源共用一套操作习惯 —— 学一次,到处用。

数据边界:本地运行、默认不联网;AI 默认关闭,只在你配好模型之后才工作 —— 它到底带走了什么,逐项写在 AI 会把什么发给模型,不是一句「我们重视隐私」。

核心特性一览

⌨️ 智能 SQL 编辑器VS Code 同款内核:上下文补全、格式化、分块执行、执行历史。
🧠 AI 同事解释 / 优化 / 修错 / 诊断 / 问答之外,还能自主排查:自己巡检、给索引建议、看同步备份状态,改动做成变更单等你批准。
🛡️ 事务模式写语句不再自动提交:先改、自查、回滚或提交,安全闭环。
✏️ 结果集直接编辑双击改值、缓冲提交,快照守卫绝不改错行。
⚡ 千万级结果集虚拟滚动 + 服务端分页 + 18× 压缩,首屏 <1s。
📊 透视与导出框选即汇总、分组下钻;CSV / Excel / JSON / INSERT 导出。
🧱 表结构与对象字段 / 索引 / 注释直接改,执行前先看完整 ALTER;视图、过程、触发器可转 ALTER 编辑。
🧑‍💼 用户与权限用户 / 角色按引擎适配,权限分层勾选,勾一次即预览 GRANT / REVOKE 差量。
🗺️ ER 关系图命名约定 + 真外键推断关系,拖拽缩放,导出 PNG / SVG。
📈 监控与运维会话 / 锁 / 指标,终止会话;备份还原、生成测试数据、全局对象搜索。

支持的数据源

17 种数据源共用一套操作习惯:同一个编辑器、同一张结果表格、同一套事务按钮与对象树 —— 换库不用换脑子。JDBC 驱动按需下载,首次连接对应类型时自动取,内网可指向私有镜像。

关系型 · 10 种MySQL、MariaDB、PostgreSQL、人大金仓 KingbaseES、Oracle、SQL Server、IBM Db2、达梦 DM、Apache Derby、H2
分析型 · 2 种ClickHouse、Apache Doris —— 连接分组里单独标为 OLAP,库 / 表 / 分区语义按各自引擎处理,不和关系型混在一起
嵌入式 / 文件 · 2 种SQLite、DuckDB —— 直接打开本地文件,不需要服务端,也不需要 Java 宿主
NoSQL · 3 种Redis、MongoDB、Elasticsearch —— 连接、库 / 集合、文档浏览与监控按原生语义走

做不到的会明说,不装作人人满分:

  • 会话事务:走 JDBC 宿主的引擎都支持(改完自查、回滚或提交);SQLite 用内核原生驱动,没有会话级事务,事务按钮直接不渲染,不会点了没反应
  • 用户与权限:MySQL / MariaDB / PostgreSQL / 金仓 / SQL Server / Oracle / ClickHouse / Doris / H2 等按各自方言给出用户、角色与分层权限;Db2、Derby 的用户由数据库外部认证提供,界面如实说明「这里没有可管理的用户」,而不是给一张空表
  • 服务监控:MySQL / MariaDB / PostgreSQL / 金仓 / SQL Server / ClickHouse / Doris 有会话、锁与库级指标;其余引擎没有监控接口,返回「不支持 + 原因」,不画空图
  • 表结构编辑:能力按引擎下发,做不到的项直接置灰并说明原因(比如部分引擎不支持字段改名、ClickHouse / Doris 的表选项建表后不可改);SQLite 只允许改列名
  • 数据传输:关系型与分析型全部支持;SQLite / DuckDB / H2 / Derby 与三种 NoSQL 没有对端写入通道,入口不出现
  • DDL 查看:能原生取到定义的引擎直接给;Db2 / Derby 按列元数据自拼一份 —— 宁可自拼,也不让「查看 DDL」点开是空的

下载与安装

前往 GitHub Releases 下载对应平台的安装包,双击安装,开箱即用。

  • Windows:安装向导 setup.exe(推荐)、企业批量部署用 .msi、不想安装就用免安装 portable.zip(解压即用,不写注册表)
  • macOS:Apple 芯片与 Intel 各一个 .dmg;未公证的 App 首次打开会被系统拦一次,按 DMG 里的说明到「隐私与安全性 → 仍要打开」即可,不用 sudo
  • Linux:Debian / Ubuntu 用 .deb(带开始菜单项),其余发行版用 .AppImage(chmod +x 后直接运行)
  • 四种形态同一套内核:桌面客户端、浏览器打开的 Web 版、命令行 dbmind、以及给 AI 客户端用的 MCP 服务器
  • 不用注册、不用云端:没有账号体系,不采集使用数据;首次连接某类型数据库时才下载对应驱动
  • 本地状态集中一处:默认 ~/.dbmind,换机器把目录搬过去就是完整迁移(详见数据目录与自愈)
macOS 首次打开:未公证的 App 一定会被系统拦一次 —— 点「好」之后到 「系统设置 → 隐私与安全性」点「仍要打开」即可,不用 sudo、不用敲命令 (DMG 里也附了这份说明)。想一次都不弹:brew install --cask --no-quarantine rick-works/tap/dbmind, 或用 curl 下载 —— 那个「已下载」标记是浏览器打的,换个下载方式系统就不会检查。

创建第一个连接

  • 左侧树点「新建连接」,选类型,填主机 / 端口 / 库 / 账号口令;文件型数据库(SQLite / DuckDB / H2 / Derby)直接选文件或目录
  • 口令不回显:保存后再打开只显示「已保存,留空不改」——留空表示沿用旧密码,不是清空
  • 分组 / 颜色 / 环境:连接可按分组收纳,支持自定义颜色;环境标记里选「生产」就获得 PROD 红徽章与全套写保护
  • SSH 隧道:跳板机支持口令或私钥(私钥可带 passphrase),端口默认 22 —— 数据库只在跳板机内网可达时用它;主机公钥走 ~/.ssh/known_hosts 加应用自己的钉扎记录,指纹变了会拒绝而不是静默连上
  • 连接级超时:默认连接 10s / 读 600s / 写 300s,字符集 UTF-8,都可按连接单独调;连接数上限也按连接配(默认由程序自适应)
  • 手改连接串:需要塞特殊参数时可直接写完整 JDBC URL,覆盖默认拼接;驱动是否就绪、下载进度都显示在弹窗底部,缺驱动时先下完再测
  • 测试连接:先测再存;打开连接时只用一次「列库」请求验证连通,失败才回头取具体原因(不再额外多打一次握手)

执行第一条 SQL

-- 光标在这条语句内时,Ctrl+Enter 只执行这一条
SELECT * FROM orders WHERE created_at > :dt;
  • 语句里的 :name 变量从变量库取值:有默认值直接执行,缺的才弹窗补填(见模板变量)
  • 多语句脚本自动分块执行,每段独立计时

四种用法:桌面 / Web / CLI / MCP

四个入口共用同一个内核、同一份本地数据(默认 ~/.dbmind):连接与设置改一处四端都看得见,可以同时开着跑。安装包把它们放在同一目录,共用一份 jre/ 与 agents/。

dbmind-desktop.exe   桌面版(双击)
dbmind-web.exe       浏览器版
dbmind.exe           命令行
dbmind-mcp.exe       给 AI 客户端的 MCP 服务器

桌面版:双击 dbmind-desktop.exe,开始菜单里也有入口。内置内核,端口自动挑 20361 附近,不需要任何参数。

Web 版:先进入安装目录再启动 —— --dist 是相对路径:

cd D:\app\DBmind
.\dbmind-web.exe --port 8787 --dist web
  • 浏览器打开 http://127.0.0.1:8787;要让局域网访问再加 --host 0.0.0.0
  • 别用 20361:那是桌面版的地盘,两边抢同一个端口只会互相添乱
  • --dist web 必须带:默认值是 ./frontend/dist(开发时的仓库路径),装好的目录里没有它,漏了就是整站 404

CLI:把安装目录加进 PATH(setx PATH "$env:PATH;D:\app\DBmind"),之后在任意位置可用。

dbmind status                 # 环境、连接数、驱动、安全开关
dbmind types                  # 支持的数据源类型
dbmind conn list              # 连接清单
dbmind test --conn 测试        # 自检(耗时 + 版本)
dbmind tables --conn 测试      # 表 / 视图(--refresh 绕过缓存)
dbmind columns --conn 测试 --table orders   # 表结构
dbmind query --conn 测试 --sql "select 1"   # 执行 SQL
dbmind query --conn 测试 --file q.sql --json  # 读文件、JSON 输出
dbmind history --limit 20     # 查询历史
dbmind setting list           # 读写设置
  • 退出码固定:0 成功、2 连接不存在、3 参数或 SQL 非法、4 被安全策略拦下、5 超时、130 取消 —— 脚本可以直接分支处理
  • --password 会留在命令历史里,日常查询用已保存的连接名

MCP:走 stdio,本身不用手动启动,配给支持 MCP 的 AI 客户端即可。

{ "mcpServers": { "dbmind": { "command": "D:\\app\\DBmind\\dbmind-mcp.exe" } } }
  • 默认只读;要放开写入给命令加 --allow-write(仍受只读连接、生产保护与危险语句拦截约束)
  • 工具清单:列连接、列类型、列表 / 视图、搜表、看表结构、执行查询、取消查询、查询历史、服务器信息
  • Codex 写进 ~/.codex/config.toml:[mcp_servers.dbmind] 加一行 command = 'D:\app\DBmind\dbmind-mcp.exe'
不用装 JDK:自带的 jre/ 会被四个端自动采用(版本 ≥17 才用);只有把 exe 挪出安装目录、或想指定别的运行时,才需要设 DBMIND_JAVA。

SQL 编辑器

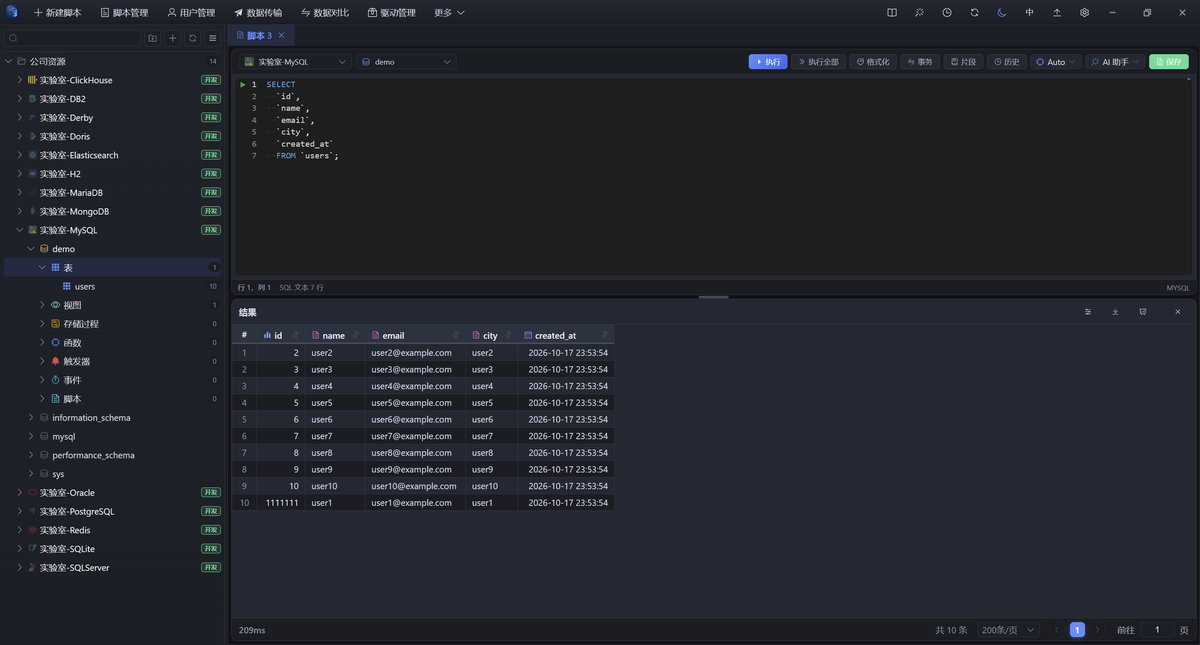
SQL 编辑器:补全、格式化、分块执行,结果与消息分栏
  • 上下文补全:按光标位置提示表 / 列 / 关键字,库结构变更后实时刷新;补全只在需要时弹,不打断输入
  • 分块执行:光标停在哪条语句就只跑哪条;有选区跑选区;「执行全部」按分号切块依次跑,每段独立计时,慢在哪一段一眼看出
  • 格式化:整篇或仅选中段一键整理,方言按当前连接自动识别
  • 批量改写:选中段转大写 / 转小写 / 压成一行;把选中的多行值复制成 IN ('a','b',…) 列表
  • 执行历史:语句、目标库、耗时、成功与否都留在本地,下拉一键回填;首页还给近 7 天趋势
  • 停止执行:长查询一键取消,不等超时;取消后如实说明是「已取消」而不是「失败」
  • 多脚本页签:一个窗口开多份脚本,各自记录所属连接;换连接不会把别的脚本也切走

脚本管理

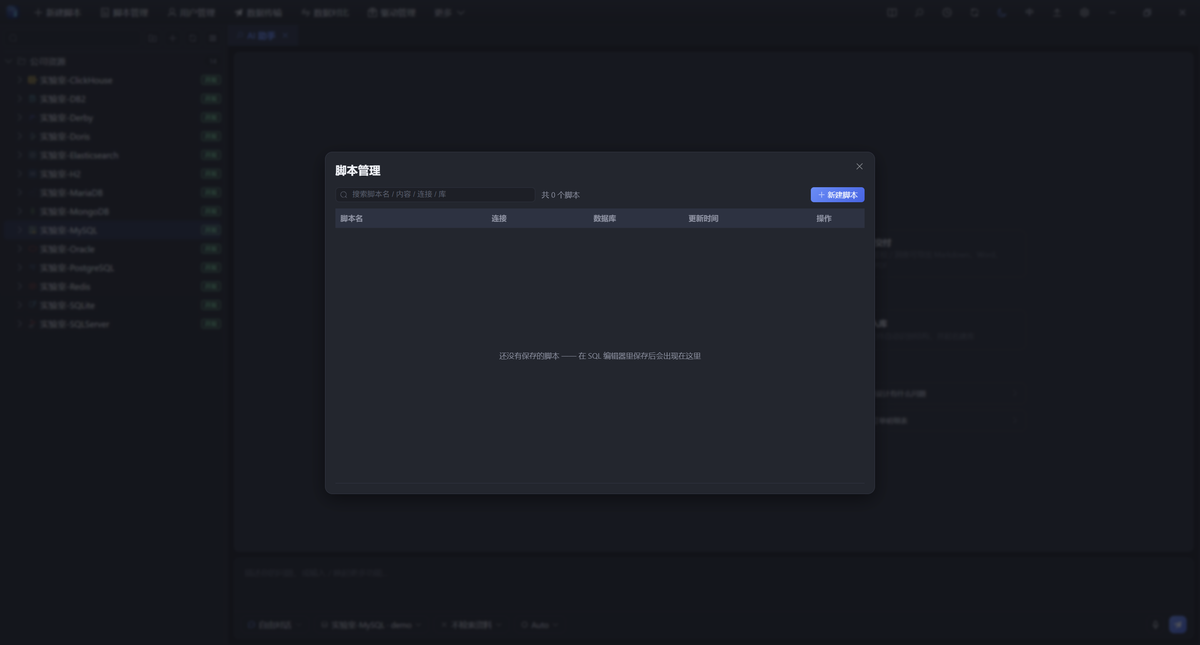
顶栏「脚本管理」是本机脚本库:把经常要跑的 SQL 存成脚本集中管理,比片段库更适合「成套的查询 / 例行巡检脚本」这类成体系的 SQL。

  • 新建 / 重命名 / 删除都在列表里完成,改名与删除按真实脚本 id 定位,改完立刻生效;内容自动保存,不用记得按 Ctrl+S
  • 打开即编辑:双击(或右键打开)脚本会开成一个普通 SQL 页签,补全、格式化、分块执行、模板变量全部可用 —— 脚本库只是「存放处」,编辑体验与手写脚本完全一致
  • 与片段 / 执行历史的分工:临时贴一段用「片段」;查「那天跑过什么」用「执行历史」;要长期维护、反复修改的成套 SQL 放「脚本管理」
  • 存本机:脚本落在本地数据目录,跟着 ~/.dbmind 一起迁移,不经过任何云端

快捷键

默认键位如下,全部可在「设置 → 快捷键」里改(存在本机,不进配置文件)。

  • 执行当前语句:Ctrl+Enter 执行全部:Ctrl+Shift+Enter 停止执行:Ctrl+F2
  • 格式化:Shift+Alt+F 注释 / 取消注释:Ctrl+/ 保存:Ctrl+S 新建脚本:Ctrl+N
  • 转大写 / 转小写:Ctrl+Shift+U / Ctrl+Shift+L 压成一行:Ctrl+Shift+M
  • 复制为 IN 列表:Ctrl+Shift+X 复制单行:Alt+Shift+L 选中当前语句:Ctrl+Shift+Y 保存片段 / 插入片段:右键菜单(存本机,跨会话保留)
  • 结果表格:刷新 F5、保存改动 Ctrl+S、加行 Alt+Insert、删行 Ctrl+Delete、回退 Ctrl+Shift+Z、向下填充 Ctrl+D、清空单元格 Delete、自适应列宽 Alt+Shift+A

AI 助手

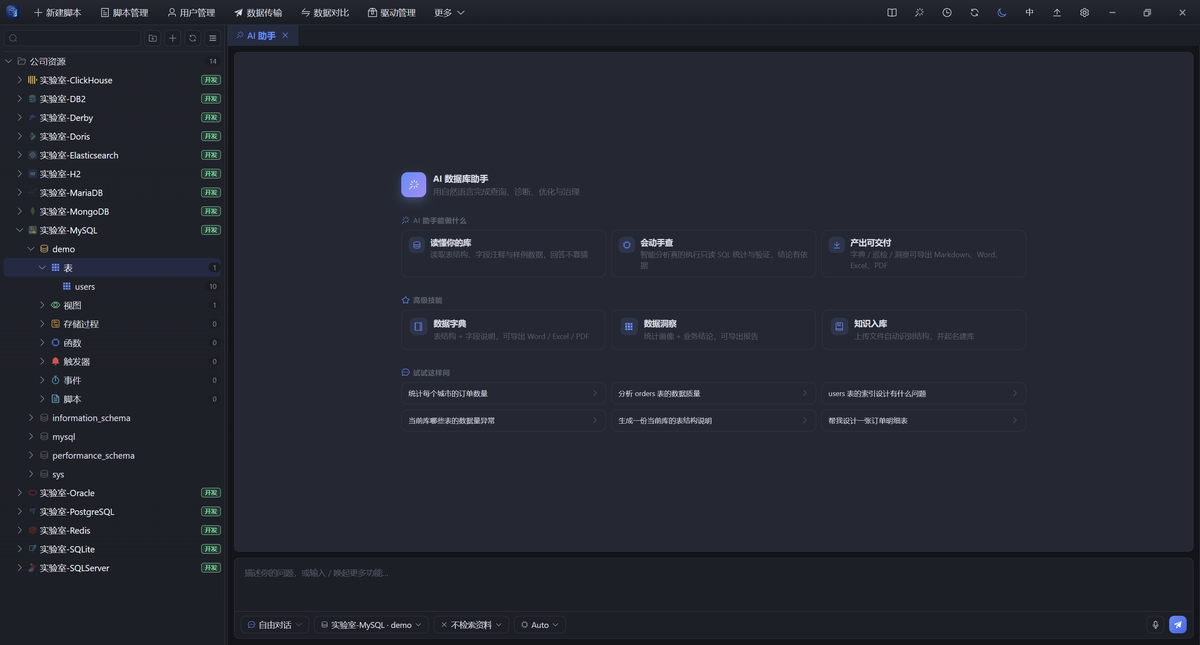
AI 助手:解释 / 优化 / 修错 / 诊断,给出的 SQL 可先看执行计划
  • 六大动作:解释、优化、改写、修错、诊断、自由对话 —— 选中 SQL 就能一键让它动手,修错会自动带上完整错误上下文,结果直接回填编辑器
  • 自主排查:打开开关,它自己调工具查库 —— 巡检表结构、给出该加的索引、看同步与备份状态、只读试跑一遍;多轮能接着上一轮的结论往下做,问两张表就展开两张
  • 变更单:要动数据或结构的动作统一生成变更单,批准才执行、高危再确认一次、执行完还能撤销 —— 执行权始终在人手里
  • 记忆与记录:说一句「记住:本库金额单位是分」,下次在同一个库提问自动带上(区分「你说过 / AI 推断」,随时可删);对话有记录,能续上一轮接着说
  • 用量与预算:每条回答脚注消耗的 token;大库上下文按预算裁剪,库级问题给全库清单(表名 + 注释)而不是整库列结构 —— 实测同一条修复从 2345 降到 956 prompt tokens
安全边界:AI 给出的 SQL 会先「看执行计划、试跑一次」再由你决定是否执行;写操作默认阻断,结构 / 数据变更要批准变更单(高危二次确认),生产库连接还要再过一道写确认。

AI 会把什么发给模型

担心数据,多半是「不知道到底发了什么」。这里不写「我们重视隐私」,直接把一次请求摊开 —— 你自己判断能不能接外部模型。DBmind 没有任何中转服务器:请求从本机直连你在设置里填的接口地址(OpenAI 兼容协议),AI 默认关闭,不配模型时一个字节都不会发。

  • 会发 · 你的问题:提问原文、当前 SQL、报错文本,加最近 6 条对话(合计上限 6000 字符,超长的一条掐中间)
  • 会发 · 表结构:表名 + 列名 / 类型 / 是否可空 / 默认值 / 主键(不含列注释);点名或命中的表最多 40 张,没点名默认前 8 张
  • 会发 · 一行样例:每张展开的表 1 行真实数据,最多前 20 列,每个值截到 24 字符 —— 模型靠它判断日期格式与状态枚举,才不会把 PAID 当成 1
  • 可关闭 · 字段脱敏:设置 →「数据脱敏」里给指定表的指定列配规则(支持 *_phone 这类通配),命中列换成 MD5 / SHA-256 摘要或 AES-256 密文(如 f3a9c2…);一份规则、四个开关:发给 AI 的内容(样例行 + 智能体只读结果)、MCP 服务返回给外部客户端的数据、结果表格的显示(只影响显示)、导出的文件(CSV / Excel / JSON / SQL 里落盘的就是打码值)。表名 / 列名 / 表注释不脱敏(脱了模型就不知道该查哪张表),你在 SQL 里手写的字面量也不脱敏
  • 会发 · 全库清单:只在你问「这个库是干嘛的」这类库级问题时,给表名 + 表注释,一行数据都不带
  • 会发 · 你自己配过的:团队术语与采纳示例、长期记忆(你说过的口径)、知识库命中片段(每段 ≤900 字符并标注来源);没配就是空的
  • 不发 · 整表数据与结果集:只有上面那 1 行样例。唯一例外是「自主排查」——它执行的只读 SQL 最多返回 100 行、裁到 3200 字符进入对话,它要「自己看数据」就得付这个代价,这一点写在明面上
  • 不发 · 密码与密钥:连接密码、SSH 口令、API Key 只存本机 ~/.dbmind/dbmind.db,接口只回「已保存」、不回显
  • 不发 · 遥测:没有使用统计、没有崩溃上报、不请求 DBmind 的任何服务器(「检查更新」只读版本号,与 AI 无关)
连样例都不想发?先开字段脱敏:设置 →「数据脱敏」按「表 + 列」配规则,手机号变 f3a9c2…(MD5)、换成 AES 密文也一样,模型照样写得出对的 SQL,但永远拿不回明文;选了 AES 的话密钥就在本机,你想解回去随时能解。「加入常见敏感列」能一键补齐手机号 / 身份证 / 邮箱 / 密码 / Token / 银行卡这类列名,改完下一次提问立即生效。
再狠一点:把端点锁死在内网:设置里打开「仅本地模型」,只要接口地址不是内网 / 本机就直接拒绝,并报出被拦的 host。放行回环、IPv4 私有段(10 / 172.16–31 / 192.168 / 169.254)、IPv6 ULA、.local / .internal / .lan / .corp / .intra 后缀,以及 DBMIND_AI_LOCAL_HOSTS 里你自己加的域名 —— 内网起的 Ollama / vLLM 照样能用,云端模型彻底出不去。对话与知识库向量化都受这条约束,且是硬拦,不是只在文档里生效。
【目标数据库】类型 MYSQL | 版本 5.7.42 | 标识符引用风格 反引号 | 分页写法 `limit {offset}, {limit}`
【表清单】共 42 张表,仅展开用到的那几张(需要其它表的字段请先说明表名)
【表 orders】
  id BIGINT not null 主键
  status VARCHAR(16) not null default 'NEW'
  amount BIGINT not null default 0
  created_at DATETIME not null
  样例:id=10231, status=PAID, amount=19900, created_at=2026-10-30 12:00:00

一个真实请求大概就这么长:模型能看出类型、枚举与日期格式,看不出你还有哪些列、哪些行。若前 20 列里就有手机号、身份证号,它们会随之发出 —— 介意就把端点锁在内网。开工前想先看规模:界面上的「这次请求花在哪」用的正是一次模型都不调的预览接口,会告诉你这次要发多少 token、各段各占多少。

智能问数

用一句中文直接问数据库要答案:「近三个月每天销售额多少?」「哪个门店客流最高?」——AI 挑表、写 SQL、真跑一遍,给出数字、图表和一句基于真实结果集的结论,全程你看得见每一步。

  • 先锁表再写 SQL:问数沿着你选的连接 / 数据库 / 模式工作;问题里的业务词(销售、客流、会员…)会自动匹配表名与表注释,锁定 3~12 张候选表(点名的表全收,不设上限),避免在几百张表里瞎猜表名
  • 数字是真的:AI 只负责生成 SQL,查询在你配的连接上真实执行;结论句里出现的每个数字都来自结果集本身,明细表格就在下面,逐格可核对
  • 图表本地切换:柱状 / 折线 / 面积 / 饼图 / 环形 / 散点 / 热力 / 漏斗 / 仪表盘随时换,不重新问模型、不花 token;结果一键导出 CSV(带 BOM,Excel 打开中文不乱码),SQL 可一键插进编辑器继续加工
  • 问不清楚会先反问:缺时间范围、口径不明时不硬答,给出 2~3 个自然的追问选项,点一下接着查;追问延续同一份上下文,不用重新交代背景
  • 过程透明可停:「选表思路」会解释这次为什么挑这几张表;生成中可随时点停止;回答尾部照例标注本次消耗的 token
  • 数据边界与 AI 助手一致:只发表结构、样例值与你的问题(逐项见AI 会把什么发给模型),行数据不整表外发

结果表格与数据编辑

  • 虚拟滚动:百万行丝滑滚动不卡顿,单元格完整内容悬浮查看;列宽可一键自适应(Alt+Shift+A)
  • 双击改值:改动先进缓冲、不立刻发请求;底栏汇总「改了几行」,确认后一次批量提交,Ctrl+Z 可逐步回退
  • 行操作:Alt+Insert 加行、Ctrl+Delete 删行、Ctrl+D 把上一格的值向下填充、Delete 清空单元格
  • 快照守卫:翻页或重跑后行号基准变了,旧缓冲自动作废并提示「缓冲已失效」—— 宁可让你重改一次,也不改错行
  • 联表编辑:JOIN 结果要改哪张表由你指定,工具不替猜列归属;带主键的表优先用主键定位,没有主键才全列匹配
  • 行数上限与超时:默认不限制返回行数(0 = 不限),可在设置里收到 100 ~ 100000 行;单语句超时默认 300 秒、可调 1 ~ 600 秒
  • 响应压缩:大结果集压缩后传输(实测 4.2 MB → 233 KB),总数异步统计,不阻塞首屏
  • 复制为(选中后右键):CSV / JSON / Markdown / IN (...) / INSERT / UPDATE / DELETE —— 选一列直接得到 IN (\n 'a',\n 'b'\n),字符串按目标方言转义,不用再手工补引号

事务模式

  • 工具栏点「事务」开启:本会话所有写语句不再自动提交,编辑器独占这条会话,别的页签借不走
  • 事务内修改自己随时可查,其他会话看不到 —— 先改、先自查,再决定
  • 满意「提交」落地;不满意「回滚」全部消失,什么都没发生
  • 关页签 / 关窗口时若有未提交改动,先弹窗确认;关闭事务模式本身也会先回滚,不会把半截改动留在库里
  • 开启 / 提交 / 回滚都进执行审计,事后能查到「谁在什么时候开的、滚没滚」
  • 适用范围:走 JDBC 宿主的引擎都支持;SQLite 没有会话级事务,按钮直接不渲染(点了也不会有反应的地方,我们选择不显示)

对象浏览器

  • 层级按引擎来:连接 → 数据库 → Schema → 表 / 视图 / 存储过程 / 函数 / 触发器 / 事件;有 Schema 层的引擎(PostgreSQL、SQL Server、Oracle、Db2)多展开一层,没有的不会凭空造一层
  • 懒加载 + 悬停预取:鼠标在某条连接上停一下,后台先把下次要用的库清单取好并缓存,点箭头时立刻出库名 —— 展开不再是「转圈等握手」
  • 右键按对象给动作:表——查看数据 / 查看 DDL / 编辑结构 / 重命名 / 删除 / 查看 ER 图;库——新建查询 / 查看 ER 图;存储过程——执行(自动开脚本填好 CALL,参数按名字生成 :变量 占位符,执行时走模板变量弹窗取值)/ 查看定义 / 编辑;其余例程——查看定义 / 转 ALTER 编辑;用户——编辑 / 授权
  • 拖对象名进编辑器:按住树上的表 / 视图 / 存储过程 / 函数 / 触发器等节点拖进 SQL 编辑器,松手即写入光标处(有选区则替换选区),省掉手敲名字拼错的机会;双击仍是打开数据预览
  • 大库不迷路:右上「对象搜索」跨整个连接按名字找表 / 视图 / 存储过程,直接定位到树节点

表结构与对象

表结构编辑:字段、索引、注释在表格里改,下方实时生成 ALTER
  • 字段表直接改:字段名、类型、长度 / 精度、可空、默认值、注释、索引,改完在下方实时生成 ALTER 语句
  • 先预览再执行:生成的是完整脚本(改类型 / 加列 / 删列 / 改默认值 / 改注释 / 重建索引),确认无误才落库
  • 改动有标记:修改行、新增行各自高亮,选中行整行染蓝,长表也不会改错行
  • 对象编辑:视图、存储过程、函数、触发器、事件右键「编辑」,取回定义转成 ALTER 送进编辑器(按连接方言自动格式化);取不到定义时如实说「未能获取」,不塞一段猜的模板
  • 新建对象:新建表、新建索引、新建视图 / 触发器 / 过程都是表单先行 —— 填完先看生成的 DDL,确认再执行
  • 索引单独一页:增删索引字段、改唯一性与索引名,改动同样进 ALTER 预览;重建索引在支持的引擎上给可执行语句
  • 不支持的能力(如部分引擎的字段改名、表选项)会置灰并说明原因,不让人填完才报错

用户与权限

用户管理:用户 / 角色清单与分层权限矩阵,勾选即预览 GRANT / REVOKE
  • 按引擎适配:MySQL / PostgreSQL / SQL Server / Oracle / ClickHouse / Doris / H2 等给出各自的用户与角色清单;外部认证的引擎(Db2、Derby)如实提示不可在这里管理,而不是给一张空表
  • 增删改都在界面上:新建用户 / 角色、改密码、删除,语句由方言生成;删除前提示会影响哪些对象
  • 分层权限矩阵:全局、服务器、数据库、Schema、表、例程按引擎实际层级出现(SQL Server 的 Schema 级与对象级各占一页),一格一个权限
  • 勾选即预览差量:底部 SQL 预览只显示「这一次改动」的 GRANT / REVOKE,取消勾选立刻变成对应撤销语句 —— 不是把全量权限重发一遍
  • 只提交变化:点「保存修改」只发差异部分,没动过的授权不受影响;保存后立即重新读取,界面里看到的就是库里现在的状态
  • 一个都不隐身:读回来的权限名即使不在预置清单里,也会作为一列显示并可取消 —— 宁可多显示一格,也不让某条授权在界面上「看不见」

监控与运维

服务监控:会话、锁与库级指标,可疑会话就地终止
  • 服务监控:当前会话、锁等待与库级指标集中显示,可疑会话可就地终止;覆盖 MySQL / MariaDB / PostgreSQL / 金仓 / SQL Server / ClickHouse / Doris,其余引擎如实返回「不支持 + 原因」
  • 备份 / 还原:按引擎原生工具导出与恢复(默认值、字符集、对象范围可配),进度与逐行日志在任务中心;失败时日志里能直接看到是哪一句报的错
  • 生成测试数据:按列类型批量造数(数值、字符串、日期各按类型生成),写进临时表或指定表,压测不用等业务造数
  • 对象搜索:不用一层层展开,直接在整个连接里搜表 / 视图 / 存储过程,按名字模糊匹配并定位到树节点
  • 表数据与 DDL 速看:右键「查看数据」直接出结果表格、「查看 DDL」出建表语句,不用先开编辑器写 SQL

任务中心

凡是「跑起来要等」的活都进任务中心:导出、导入、整库转储、数据对比、数据传输、备份 / 还原、生成测试数据。

  • 后台执行:关掉弹窗、切到别的页签都不会中断;完成后系统通知,失败给原因
  • 进度与日志实时刷新:任务阶段(准备 / 读取 / 写入 / 收尾)、已处理行数、速率都能看到;任务日志最多保留 4000 行,够定位一次失败
  • 可停止:中途取消会真的停掉源端与目标端,不会「界面说停了、服务端还在跑」;取消后如实标为「已取消」,不报成写入失败
  • 产物可下载,也可丢弃:导出产物落在系统临时目录,取回后即删;过期自动清理
  • 终态记录有上限:结束的任务保留 30 分钟供查看,快照文件只留最新 500 份 —— 任务中心不会变成第二个垃圾场

数据目录与自愈

所有本地状态都在一个目录里:默认 ~/.dbmind(元数据库 dbmind.db、驱动缓存 drivers/、日志 logs/、任务快照 tasks/、导出临时目录),可用 DBMIND_HOME 改位置。

  • 开机后台自愈:回收元数据库的空闲页(删了又写的表只把页挂回空闲链,文件不会自己变小)、清理超过 24 小时的装载残留临时文件、任务快照只留最新 500 份 —— 全部在后台线程做,失败只记日志,绝不影响启动和查询
  • 回收有门槛:空闲空间达到 8 MB 且占比超过 20% 才动手,避免为了几百 KB 反复重写整个库文件
  • 只还空洞,不删记录:查询历史与审计是用户数据,删不删只由「清空日志」按钮和保留策略决定,后台清扫一条都不动
  • 清空即回收:设置里点「清理缓存 / 清空日志」,当场把腾出来的空间还给文件系统,并回显释放了多少 MB
  • 实测效果:一个用了几个月的目录 1.5 GB → 223 MB,其中元数据库 805 MB → 54 MB

ER 关系图

ER 关系图:命名约定 + 外键推断,可拖拽布局并导出 PNG / SVG
  • 库节点右键「查看 ER 图」:按命名约定(_id / _no / _code 等)与真实外键推断表间关系,没有外键的库也能画出骨架
  • 两种来源分开标:真实外键优先,命名推断的连线标明置信度 —— 图好看不等于关系成立,哪条是猜的写清楚
  • 纯规则推断,不消耗模型:这一步不调 AI、零 token,任何时候都能开
  • 自动布局(从左到右分层)后可拖拽表卡片、滚轮缩放、空白处平移、按表 / 列搜索高亮
  • 一键导出 PNG / SVG,直接贴进设计文档;导出用固定亮色配色,深色主题下截图也不会糊成一片

模板变量

把重复查询变成填空题:SQL 里写 :name 占位符,变量集中在工具条「变量」按钮里管理(名称 / 默认值 / 备注),编辑器里打 : 直接从变量库补全。

SELECT * FROM orders
WHERE dt = :dt AND org = :org;
  • 有默认值不打扰:执行时变量库里有默认值的变量自动套用,不弹窗;缺的才弹窗补填,填过的值自动存入变量库,下次同变量不再询问
  • 怎么认变量::name(字母 / 下划线开头,大小写不限,可含数字 / 下划线,匹配不区分大小写);字符串字面量里的冒号不误判('12:30' 安全),PostgreSQL 的 ::type 类型转换也不会被当成变量
  • 怎么拼值:函数(NOW()、COALESCE(a,b) 等)、纯数字、null(不分大小写)原样写入;其余按单引号字符串转义(内部的 ' 变成 '')—— 不做字符串拼接式注入
  • 全局生效:变量库存本机,所有脚本页签共用;弹窗里留空的变量拒绝执行,不会悄悄塞一个空串进 SQL;同一个变量在语句里出现多次,用的是同一个值

SQL 片段库

脚本管理:常用 SQL 存成片段,随时调出
  • 选中 SQL → 右键「保存片段」,命名保存(没选中就存全文);不给名字时默认取首行前 30 字 —— 下拉里的「存为片段」按钮已去掉,同一个动作不留两个入口
  • 跨会话保留,最多 100 条;点顶部「片段」看列表,或右键「插入片段 »」挑一条:有选区就替换选区,否则插到光标处;「清空片段」在同个子菜单里
  • 存在本机浏览器存储里,不跟随数据目录迁移 —— 换机器请用「导出」带走数据,或把常用 SQL 存成脚本页签

数据透视

  • 结果表格里框选区域 → 一键汇总:计数 / 求和 / 均值 / 最小值 / 最大值,指标列只列数值列,不会让你对着字符串点「求和」
  • 按列分组透视、按指标排序、TOP-N 只看前 10 / 20 / 50 / 100 组,再点开组看明细
  • 纯前端计算:直接用已经取回的结果集在浏览器里累加,不再发 SQL、不占数据库资源 —— 分析一份刚查出来的数据,不会因此多压一次线上库
  • 分组结果最多保留 2000 组、下钻明细取前 10 列:超过就明确告诉你被截断,而不是悄悄少显示几行

导出与传输

导出与传输:格式和目标一次配好,长任务转后台
  • 导出格式:CSV / Excel / JSON;整库转储与脚本导出还提供 INSERT / UPDATE / DELETE 语句与纯 DDL,直接把数据变成可回放的 SQL
  • 导出没有行数上限:后端自己分页(每批 5 万行)往外写,几十万行的表也是后台稳稳跑完,不会因为「一次查太多」被内存拖死
  • 整库转储:CSV / Excel / JSON 一律打包成 zip(一个表一个文件),SQL 类输出直接给一个 .sql
  • 导入:CSV / JSON / Excel,按目标列类型转换(日期、数值、空值各按类型处理),每批写 200 行;单文件上限 256 MB,老式 .xls 明确不支持并提示另存为 .xlsx
  • 长任务后台跑:导出 / 整库转储 / 导入各自是独立任务,关窗口不中断,进度与日志在任务中心,完成有系统通知
  • 产物不占盘:导出文件落在系统临时目录,取回后即删
  • 导出也能脱敏:设置 →「数据脱敏」里打开「数据导出」后,命中规则的列写进文件时就是摘要 / 密文(生成 UPDATE / DELETE 脚本时主键列保持原文,否则语句定位不到行)

备份与还原

库级备份 / 还原直接在客户端里点出来:调各数据库官方原生的导出导入工具链(mysqldump、pg_dump / pg_restore 等),格式与官方一致,不造私有轮子。

  • 入口:连接(或库)右键 → 备份 / 还原,选目标与范围后开始;任务进任务中心,可以后台跑、完成后系统通知
  • 大文件稳:备份边收边写落盘,不再整块塞进内存;中途失败或取消不会留下半截的"假成功"文件
  • 取消是真取消:界面点了停止,后台的 dump / restore 进程跟着停,不会"界面显示已取消、进程还在偷偷跑完"
  • 还原有护栏:还原会覆盖目标库数据 —— 生产连接默认拦截,与全局安全护栏同一套口径;执行前想清楚,或临时关闭护栏
  • 前提:本机装有对应数据库的 dump / restore 命令行工具(连接时驱动装的是 JDBC 包,不含这些工具)

生成测试数据

建好表结构却没数据可玩?按表结构批量生成贴近真实的测试数据:行数你来定,每列的取值规则你来挑,写进目标表让联调、演示、性能测试立刻有东西可查。

  • 按列定制规则:整数 / 小数给区间,字符串给长度、枚举集合或正则,日期给时间窗,还有自增序列与"从字典里挑"的枚举列 —— 类型与列约束(NOT NULL、唯一)自动对齐表结构
  • 行数自己定:从几十行冒烟到几十万行压测都行;大批量分批写入,进度在任务中心可见
  • 写入前看得到:生成的数据先预览再落地;目标表已有的数据不会被清掉,新行是追加进去的
  • 护栏照常:往生产连接灌数据默认拦截;给测试库灌之前确认连接的环境标记没标错

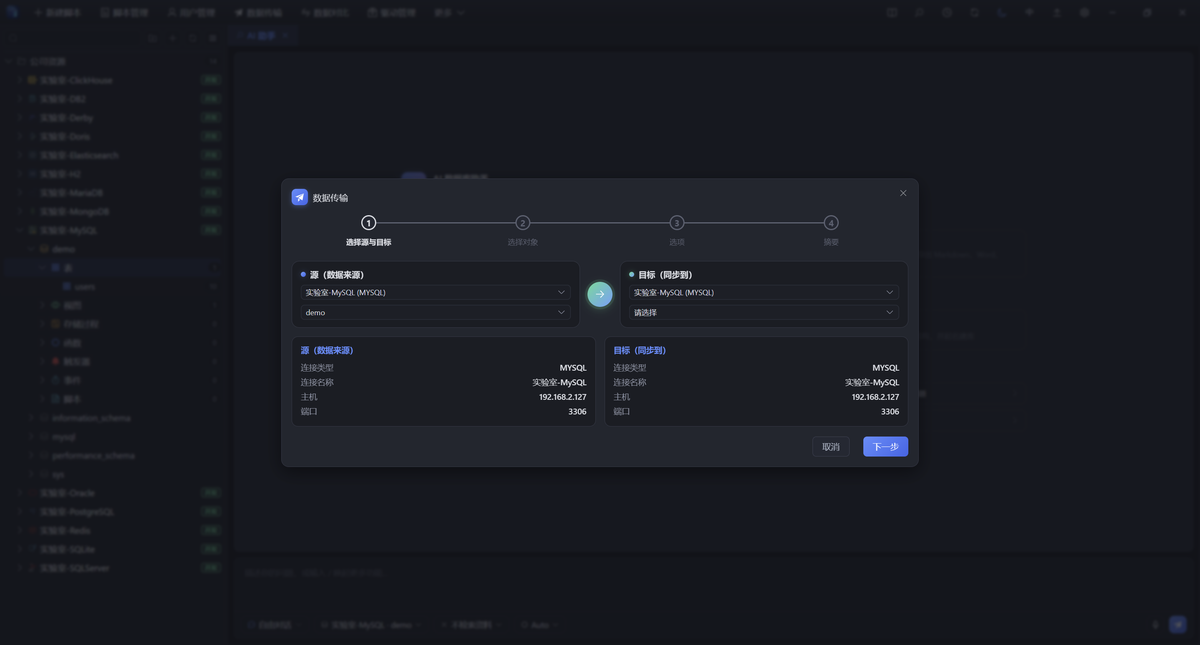
数据对比与传输

  • 对比三种口径:只比结构、只比数据,或两者一起比;结构差异细到类型 / 长度 / 可空 / 默认值 / 主键 / 索引 / 外键
  • 数据对比:以主键 / 唯一键为基准逐行比,差异样本可调(10 ~ 500 行);单侧最多约 200 万行参与,二进制列自动排除避免误判
  • 传输对象:表、视图、函数、存储过程、触发器、事件一次勾选;先出计划(目标端要建什么、写多少行)再执行
  • 三种写入模式:直接插入 insert、清空后插入 truncate_insert、按主键合并 upsert(引擎原生 upsert 可用时走原生,否则退化为「查后写」两段式)
  • 同实例走直拷:源与目标在同一实例时,直接让数据库自己 insert into … select …,数据根本不经过客户端 —— 20 万行 6 列实测 6 秒,走客户端管道是 239 秒
  • 跨实例也能快:自动按行数分片、多连接并发、传输链路压缩,同一份数据 239 秒 → 35 秒;并发数、分片数、行 / 字节限速都可调
  • 按表加过滤条件:同一批对象里,可以给某张表单独写 where 只搬一部分数据(按表名给条件)
  • 跨环境同步(开发 → 测试 → 生产)不用再手工拼脚本,生产连接上的写入仍受 PROD 保护;中途取消会真的停下两端,不会「界面说停了、服务端还在写」

安全护栏

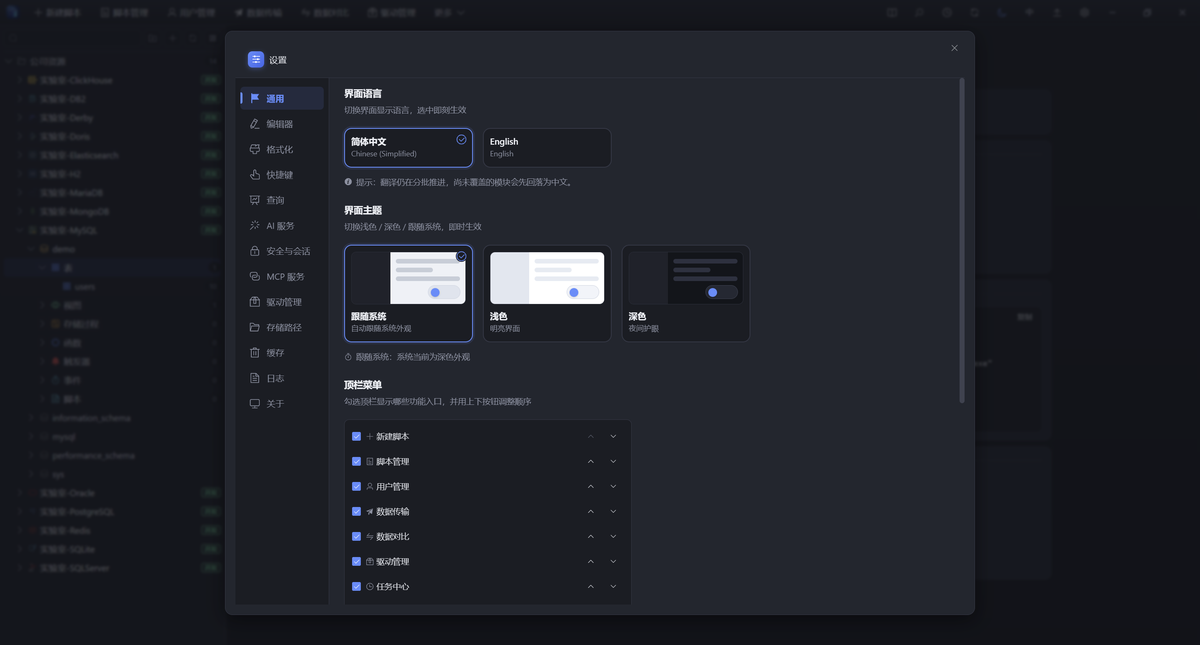
设置中心:生产库保护、返回行数上限、AI 与外观
  • PROD 保护默认开启:标注为生产的连接,所有改动数据或结构的操作(执行脚本、改表、编辑数据、导入 / 同步 / 还原)默认一律拦下,查询不受影响;开发 / 测试 / 未标注的库照常,确需临时改生产可一键关闭
  • PROD 标记全程外显:页签、连接下拉、对象树都带红色徽章,连错库这件事从源头消失
  • 写操作二次确认:INSERT / UPDATE / DELETE、DROP、TRUNCATE 执行前先预览影响,确认才走
  • 超时与行数预算:单语句超时默认 300 秒(可调 1 ~ 600),返回行数默认不限(可收到 100 ~ 100000);误点 SELECT * 也不会把客户端拖死
  • AI / MCP 通道默认只读:两层锁 —— 语句分类先拒,内核的 AI 通道闸门再拒一次;已递 SQL 的 AI 请求要动数据,只能生成变更单等你批准
  • 全程审计:执行过的语句、事务动作、AI 调用都留痕,可查可导出(见执行审计)

驱动管理

  • 按需下载:首次连接某类型时自动从 Maven 取对应 JDBC 驱动并缓存到本地,不预装一堆用不到的 jar
  • 进度可见:下载中在连接弹窗底部与设置页显示文件名、第几个、已下载多少,长驱动不会「卡住没反应」
  • 可替换可修复:设置里能重新下载 / 修复某个驱动;内网可把镜像换成私有仓库,或直接把 jar 放进数据目录的 drivers/
  • 驱动跑在独立 Java 宿主:JDBC 驱动由单独的 Java 进程加载,驱动崩溃不会带倒客户端;宿主需要 Java 17+,启动脚本会自动探测并固定(也可用 DBMIND_JAVA 指定)

执行审计

执行审计与数据治理:谁在什么时候执行了什么
  • 每条语句自动留痕:语句、连接与库、返回行数、耗时、成功与否、错误码、执行时间、来源(界面 / 任务 / AI),都写进本地元数据库
  • 事务动作同样留痕:开启 / 提交 / 回滚各一条记录,事后能查到「谁在什么时候开的、滚没滚」
  • AI 调用单独记账:时间、类型、提问原文写进独立的 AI 审计表 —— 与查询历史分开,既方便排查「AI 到底问了什么」,也不会混进 SQL 历史
  • 保留策略可配:按条数(history.maxEntries)或天数(history.retentionDays)自动裁剪,默认都是 0 = 不自动删;审计级别默认记录全部
  • 看得见的地方:编辑器内的执行历史下拉、首页近 7 天趋势图、设置页的日志与「清空日志」(清空会同时清掉查询历史与 AI 审计)

常见问题

  • 需要联网吗?除了「第一次连接某类型时下载驱动」和「检查更新」,其余全部本地完成;AI 也要你自己配了模型才会发请求
  • 我的数据存在哪?默认 ~/.dbmind(元数据库、驱动、日志、任务快照),可用 DBMIND_HOME 改到别处 —— 备份与迁移搬这一个目录就够了
  • 「驱动宿主未就绪」?宿主需要 Java 17+,启动脚本会自动探测并固定;也可设 DBMIND_JAVA 指向 Java 17+ 的 java 可执行文件
  • 内网无法下载驱动?切换驱动镜像到内网仓库,或手动放入数据目录的 drivers/
  • 事务按钮不显示?SQLite 等嵌入式引擎没有会话级事务,按钮自动隐藏;不是坏了
  • 编辑提交报「缓冲已失效」?翻页 / 重跑后行号基准变了,重新双击编辑即可 —— 这是防改错行的保护
  • 结果只回来一部分?看两处:语句里自带的 LIMIT,以及设置里的「返回行数上限」(默认不限,被设过就按 100 ~ 100000 截断)
  • AI 为什么让我先给表名?大库只展开你点名或问题里提到的表;库级问题只给全库清单(表名 + 注释)。点名表名后它会拿到那张表的真实列结构,写出来的 SQL 才对得上
  • 支持哪些平台?Windows(安装包 / MSI / 免安装 zip)、macOS(Apple 芯片与 Intel)、Linux(deb / AppImage);另有 Web、CLI 与 MCP 三种形态
  • 能管 NoSQL 吗?能连 Redis / MongoDB / Elasticsearch,库与集合浏览、文档查看、监控各按原生语义;SQL 编辑器只服务 SQL 数据源

社区

社区暂未建立。使用中遇到问题、有功能建议,欢迎通过以下方式联系我们:

也欢迎加入我们一起建设 DBmind —— 文档、翻译、驱动适配、功能开发,每一份贡献都算数。
准备试试 DBmind?

免费使用 · Windows / macOS / Linux · 无需注册,下载即用